用 BaseHalf 和 AI 入门 Base64
我们在 BaseHalf 里打开真实的 base64-encoding 文件夹,把编码、填充和变体笔记摆成卡片,旁边放着 RFC 4648 的本地副本,把这些笔记写进练习卡片的 upstream,再在 Agent Area 用 Claude Code 把四道 Base64 题判为正确。
检查一段 Base64 时,最好把字母表、填充规则和变体放在各自的卡片上,让 RFC 待在同一个文件夹里,让智能体同时看到这些笔记和练习答案。我们在桌面上建了一个普通文件夹,放进六份短 Markdown 和一份 RFC 4648 的本地副本,再用 BaseHalf 打开。窗口标题变成 base64-encoding,侧栏列出每一个文件,每个文件变成卡片。我们在右侧 Agent Area 启动了 Claude Code,并选中了练习卡片。
磁盘上的路径是 Desktop/basehalf-learn-sessions/base64-encoding/。画布上的文件是这些:
base64-encoding/
  00-goal.md
  01-encoding.md
  02-padding.md
  03-variants.md
  04-practice.md
  rfc4648.txt
  sources.md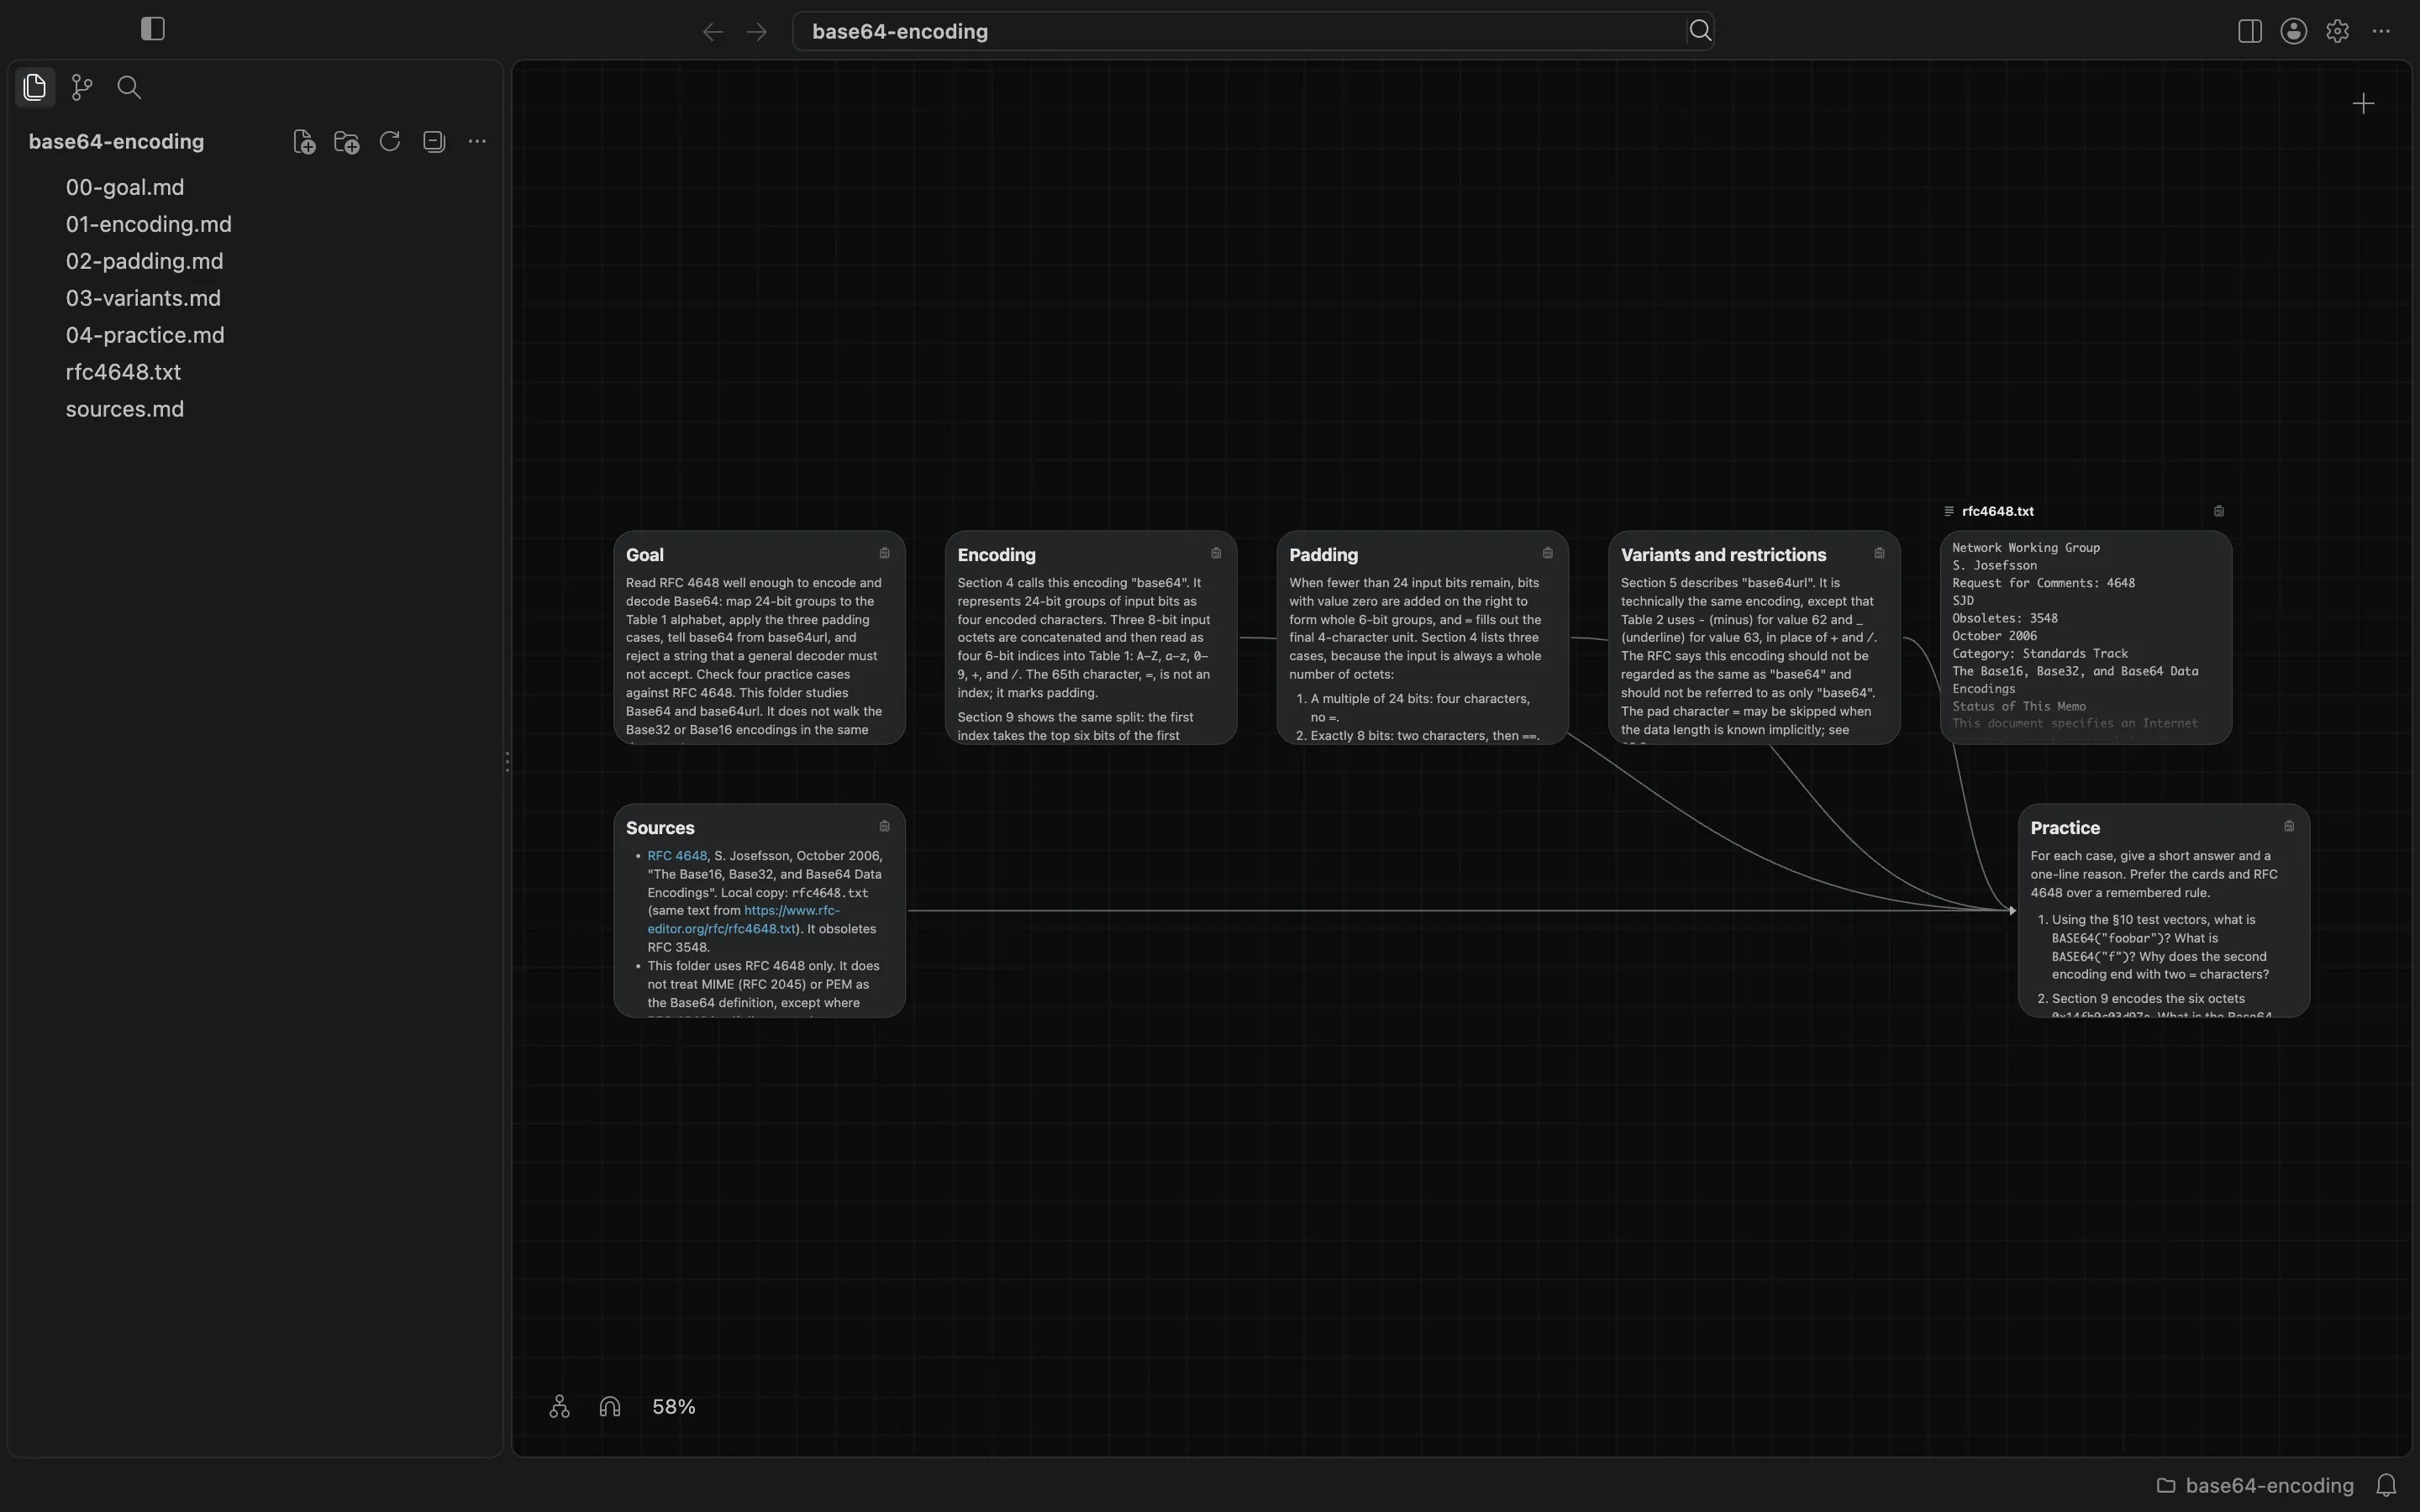
每张卡片写了什么
00-goal.md 划定范围:编码和解码 Base64,把 24 位一组映射到表 1 的字母表,套用三种填充情形,区分 base64 和 base64url,并拒绝一般解码器不得接受的字符串;再对照 RFC 4648 核对四道练习。这个文件夹学的是 Base64 和 base64url,并不走同一份文档里的 Base32 或 Base16。
01-encoding.md 记下第 4 节的过程,RFC 把这种编码叫做 "base64":每组 24 位输入变成 4 个编码字符。三个 8 位八位组先拼在一起,再按四个 6 位索引去查表 1:A-Z、a-z、0-9、+ 和 /。第 65 个字符 = 不是索引,它表示填充。卡片还指向第 9 节的例子 0x14fb9c03d97e,它编码成 FPucA9l+。
02-padding.md 记下第 4 节末尾的三种情形。输入是 24 位的整数倍时,输出是 4 个字符,没有 =。正好 8 位时,是两个字符再加 ==。正好 16 位时,是三个字符再加一个 =。第 3.2 节写明:除非引用本文件的规范明确另有规定,实现 MUST 在编码数据末尾补上适当的填充字符。卡片还记下第 10 节的测试向量 BASE64("foo") = "Zm9v"、BASE64("fo") = "Zm8=" 和 BASE64("f") = "Zg==",以及第 3.5 节的规则:符合规范的编码器 MUST 把未使用的填充位设为零。否则,解码器 MAY 拒绝这段编码。
03-variants.md 记下第 5 节的 base64url:编码过程相同,只是表 2 用 -(minus)表示 62、用 _(underline)表示 63。RFC 写明,这种编码不应看作与 "base64" 相同,也不应只被称为 "base64"。在数据长度可以从别处知道时,可以省略填充字符,见第 3.2 节。卡片还记下第 3.1 节:除非引用规范明确要求编码器在特定字符数之后插入换行,实现 MUST NOT 给 base 编码数据添加换行。MIME 的 76 字符行长是 MIME 自己的规则,不是一般 Base64 规则。第 3.3 节写明:除非引用规范明确另有规定,一般解码器遇到字母表以外的字符时 MUST 拒绝。RFC 举的例子是 MIME:它会忽略非字母表字符,包括相邻的 CRLF。
sources.md 链接了 RFC 4648(S. Josefsson,2006 年 10 月,"The Base16, Base32, and Base64 Data Encodings"),本地副本是 rfc4648.txt。这份 RFC 取代了 RFC 3548。这个文件夹只用 RFC 4648。除了 RFC 4648 自己讨论到的地方,我们不把 MIME 或 PEM 当作 Base64 的定义。
练习笔记上的 upstream
练习笔记把三张概念卡片和 sources.md 写进了 upstream 列表。画布上,从 01-encoding、02-padding、03-variants 和 sources 出发的线,连进了 04-practice。文件开头是:
upstream:
  - 01-encoding.md
  - 02-padding.md
  - 03-variants.md
  - sources.md
这份列表会留在文件里。选中状态不会:它只在 BaseHalf 打开时写在 .bh/cache/selection.yaml。我们选中了练习卡片,状态栏显示 04-practice,然后才请 Claude Code 判题。
四道练习
练习卡片要求每道题写简短答案和一行理由,优先依据卡片和 RFC 4648,而不是靠记忆中的规则。
-
用第 10 节的测试向量:
BASE64("foobar")是什么?BASE64("f")是什么?为什么第二个编码以两个=结尾? -
第 9 节把六个八位组
0x14fb9c03d97e编码。Base64 输出是什么?值 62 对应哪个字符?同一串比特的 base64url 写法是什么? -
Zg=是"f"在一般情形下合法的 Base64 编码吗?省略填充的Zg呢?Zh==是"f"的规范编码吗? -
一般的 RFC 4648 编码器该给一段很长的 Base64 加上换行吗?一般解码器该接受后面跟一个换行的
Zm9vYmFy吗?
我们的答案:
-
Zm9vYmFy,以及Zg==。"f"是一个八位组,正好 8 位,所以第 4 节情形 (2) 规定:最后一组是两个字符,后面跟两个=填充字符。第 10 节的测试向量也是这一对。 -
FPucA9l+。最后一个索引是 62,表 1 写成+。表 2 把 62 写成-,所以 base64url 写法是FPucA9l-。第 5 节写明,base64url 不应只被称为 "base64"。 -
不是,不是,也不是。
Zg=只有一个填充,但"f"属于 8 位那种情形,第 4 节要求两个=。Zg省略了填充;第 3.2 节写明,除非引用规范明确另有规定,实现 MUST 补上适当的填充字符,在一般情形下填充是必需的。Zh==不是规范编码:"f"是0x66,未使用的填充位必须为零,结果是Zg==(第 3.5 节和第 4 节)。解码器 MAY 拒绝Zh==。 -
不该,也不该。第 3.1 节写明,除非引用规范明确要求编码器在特定字符数之后插入换行,实现 MUST NOT 添加换行;MIME 的 76 字符限制不是一般 Base64 规则。换行不在表 1 的字母表里,所以第 3.3 节规定,一般解码器 MUST 拒绝这串字符,除非引用规范(RFC 举的例子是 MIME)明确要求忽略非字母表字符。
Claude Code 实际说了什么
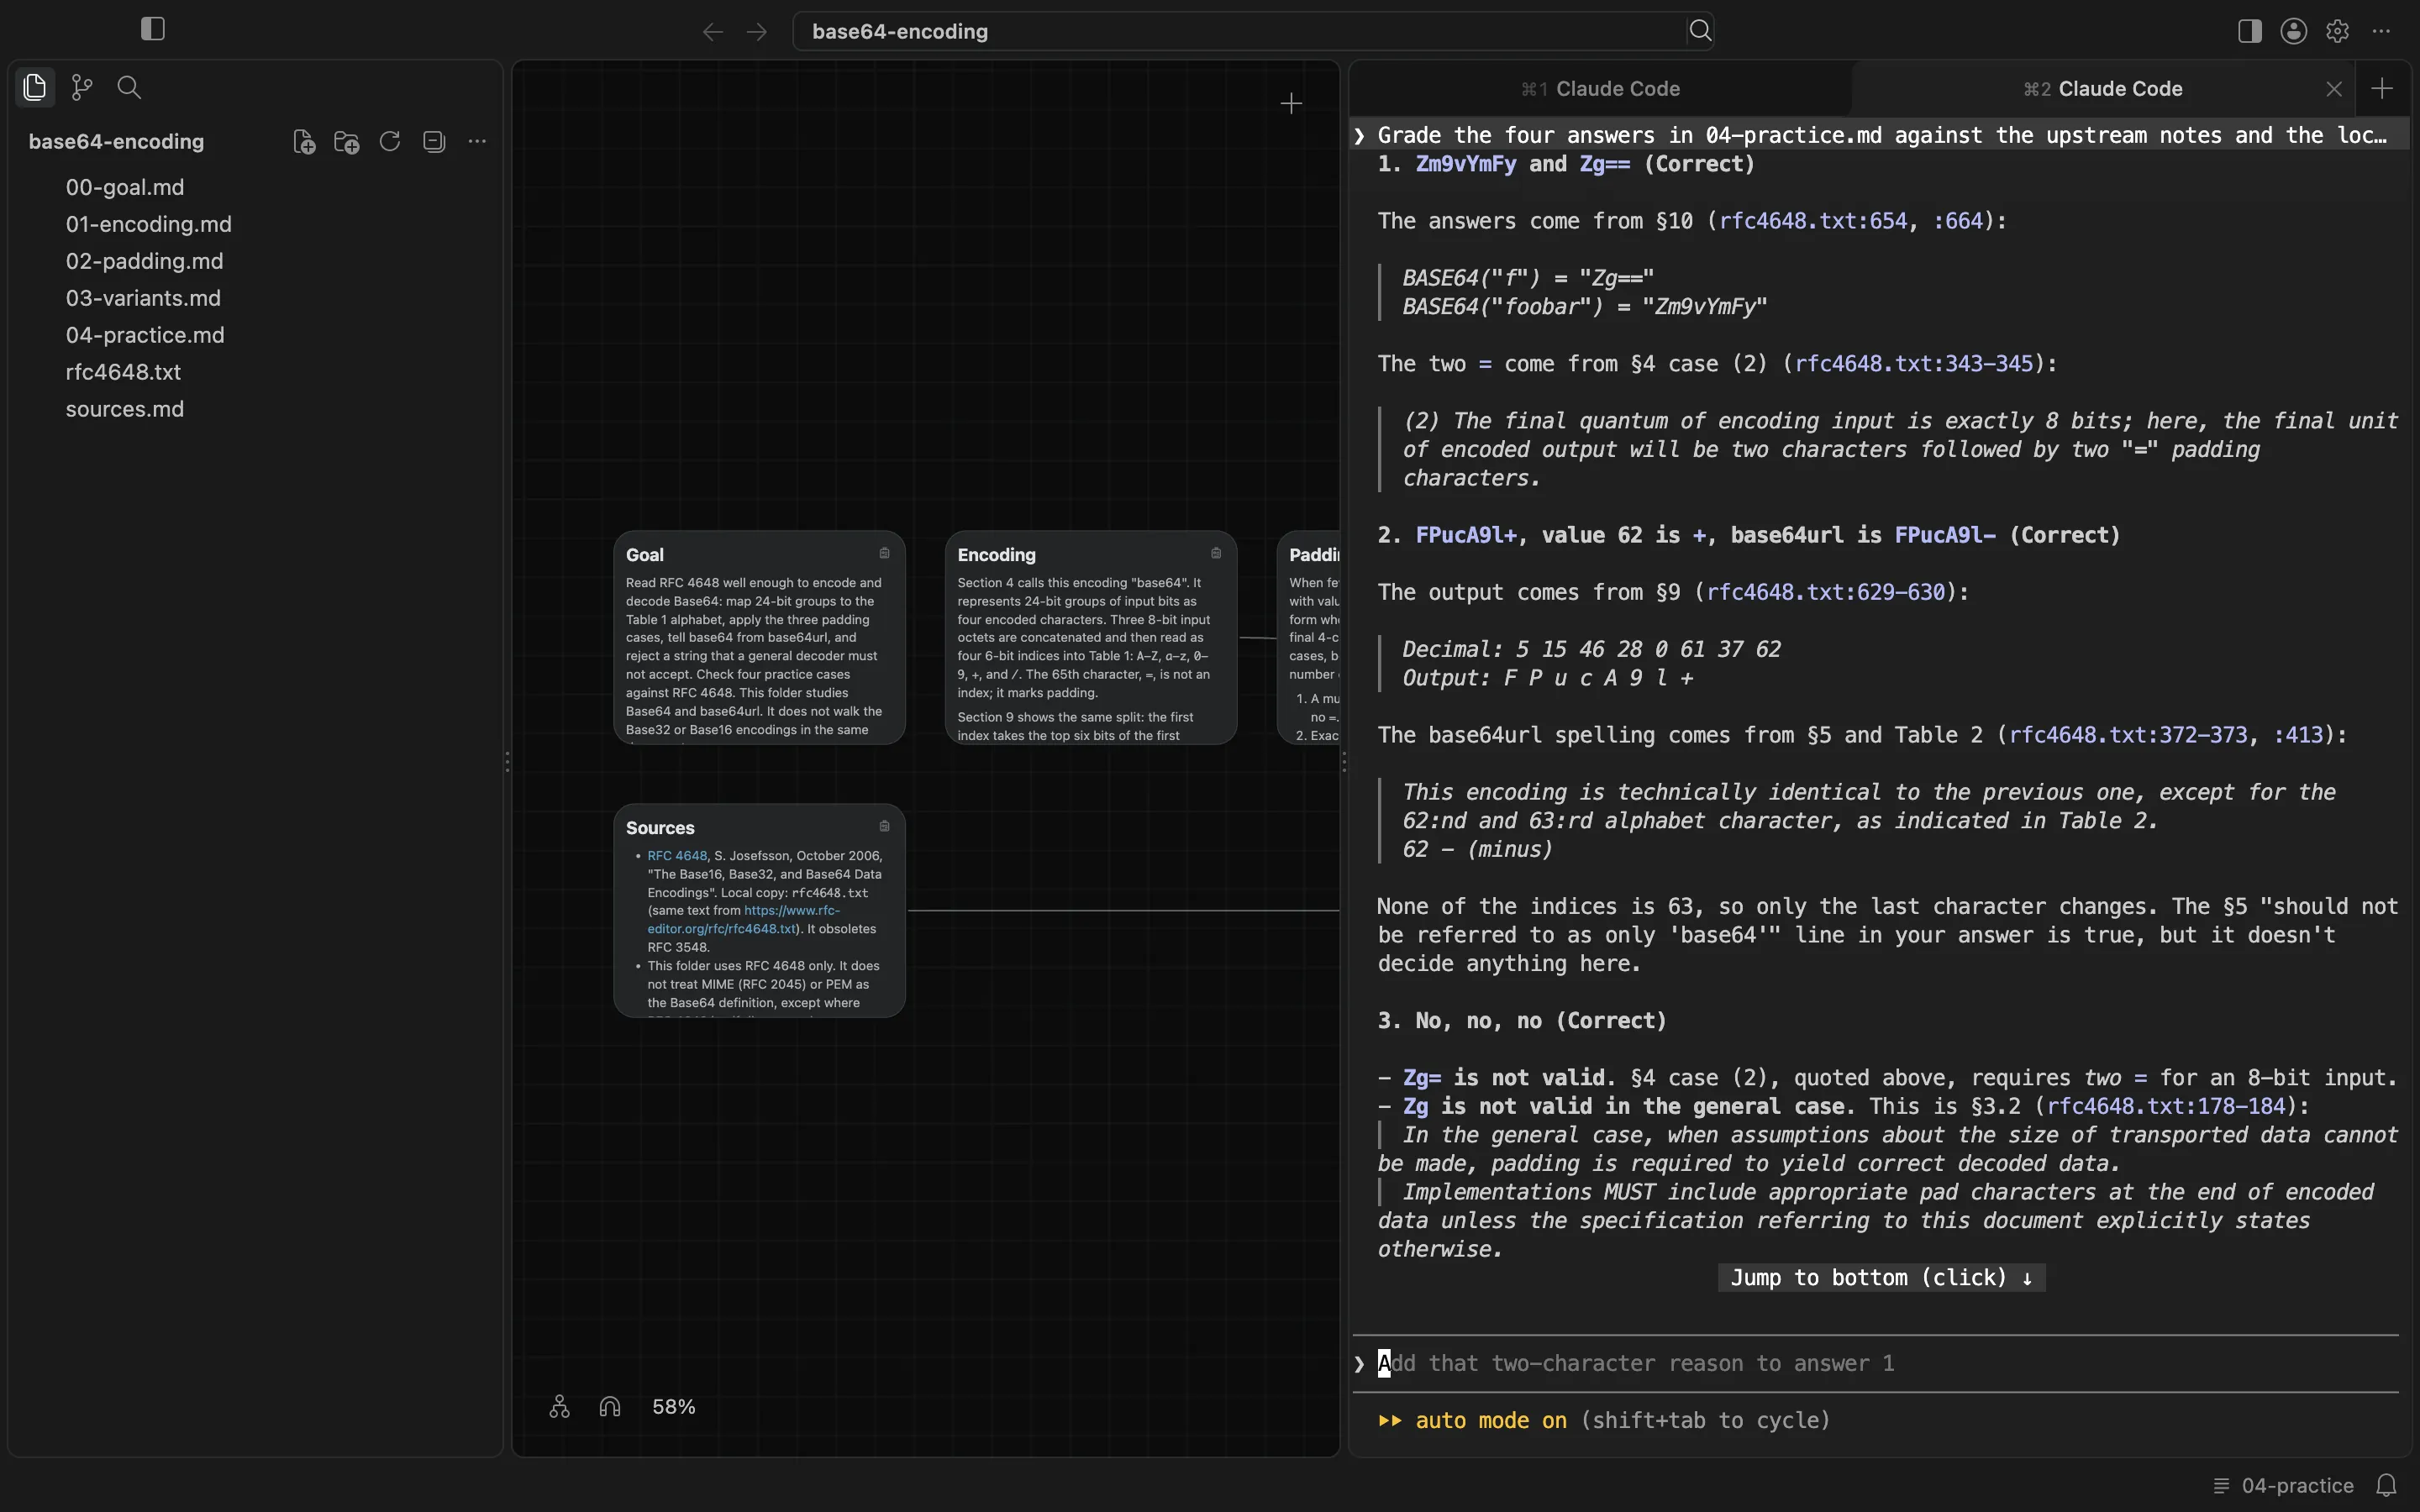
把回复当作草稿来看。这次会话里,Claude Code(v2.1.325,窗口里显示为 Opus 5.5、xhigh 工作强度、Claude Ultra)说四道题的答案都正确,每一道都符合 upstream 笔记和本地的 rfc4648.txt,并且它没有改任何文件。这次运行用了 1 分 8 秒。磁盘上练习文件的时间戳和会话开始前一样。它还说自己跑了一个简短的 Python 核对,结果与每道答案一致,并说明那只是 sanity test,真正做决定的是 RFC。我们按这个态度处理,并对照本地 RFC 核对了引文。
第一道题,它引用了第 10 节的测试向量 BASE64("f") = "Zg==" 和 BASE64("foobar") = "Zm9vYmFy",以及第 4 节情形 (2):最后一组正好是 8 位时,编码结果是两个字符再跟两个 = 填充字符。我们核对了这两处,引文成立。它标在引文旁边的部分行号有几处偏差,所以我们看的是章节正文,而不是那些行号。它还补了一条可选说明:理由也可以写清为什么会有两个字符。8 位后面补上四个 0 比特,就得到两个 6 位组,两个 = 再填满 4 个字符的一组。这也符合第 4 节。
第二道题,它同意输出是 FPucA9l+,引用了第 9 节的十进制行 5 15 46 28 0 61 37 62 和输出行 F P u c A 9 l +。它引用第 5 节:这种编码在技术上相同,只是第 62 和第 63 个字母表字符不同,表 2 把 62 写成 -(minus),所以 base64url 写法是 FPucA9l-。这些索引里没有 63,因此只有最后一个字符会变。它还说,我们答案里那句「base64url 不应只被称为 "base64"」是对的,但并不能决定这道题。我们核对了这些段落,引文和表项都成立。
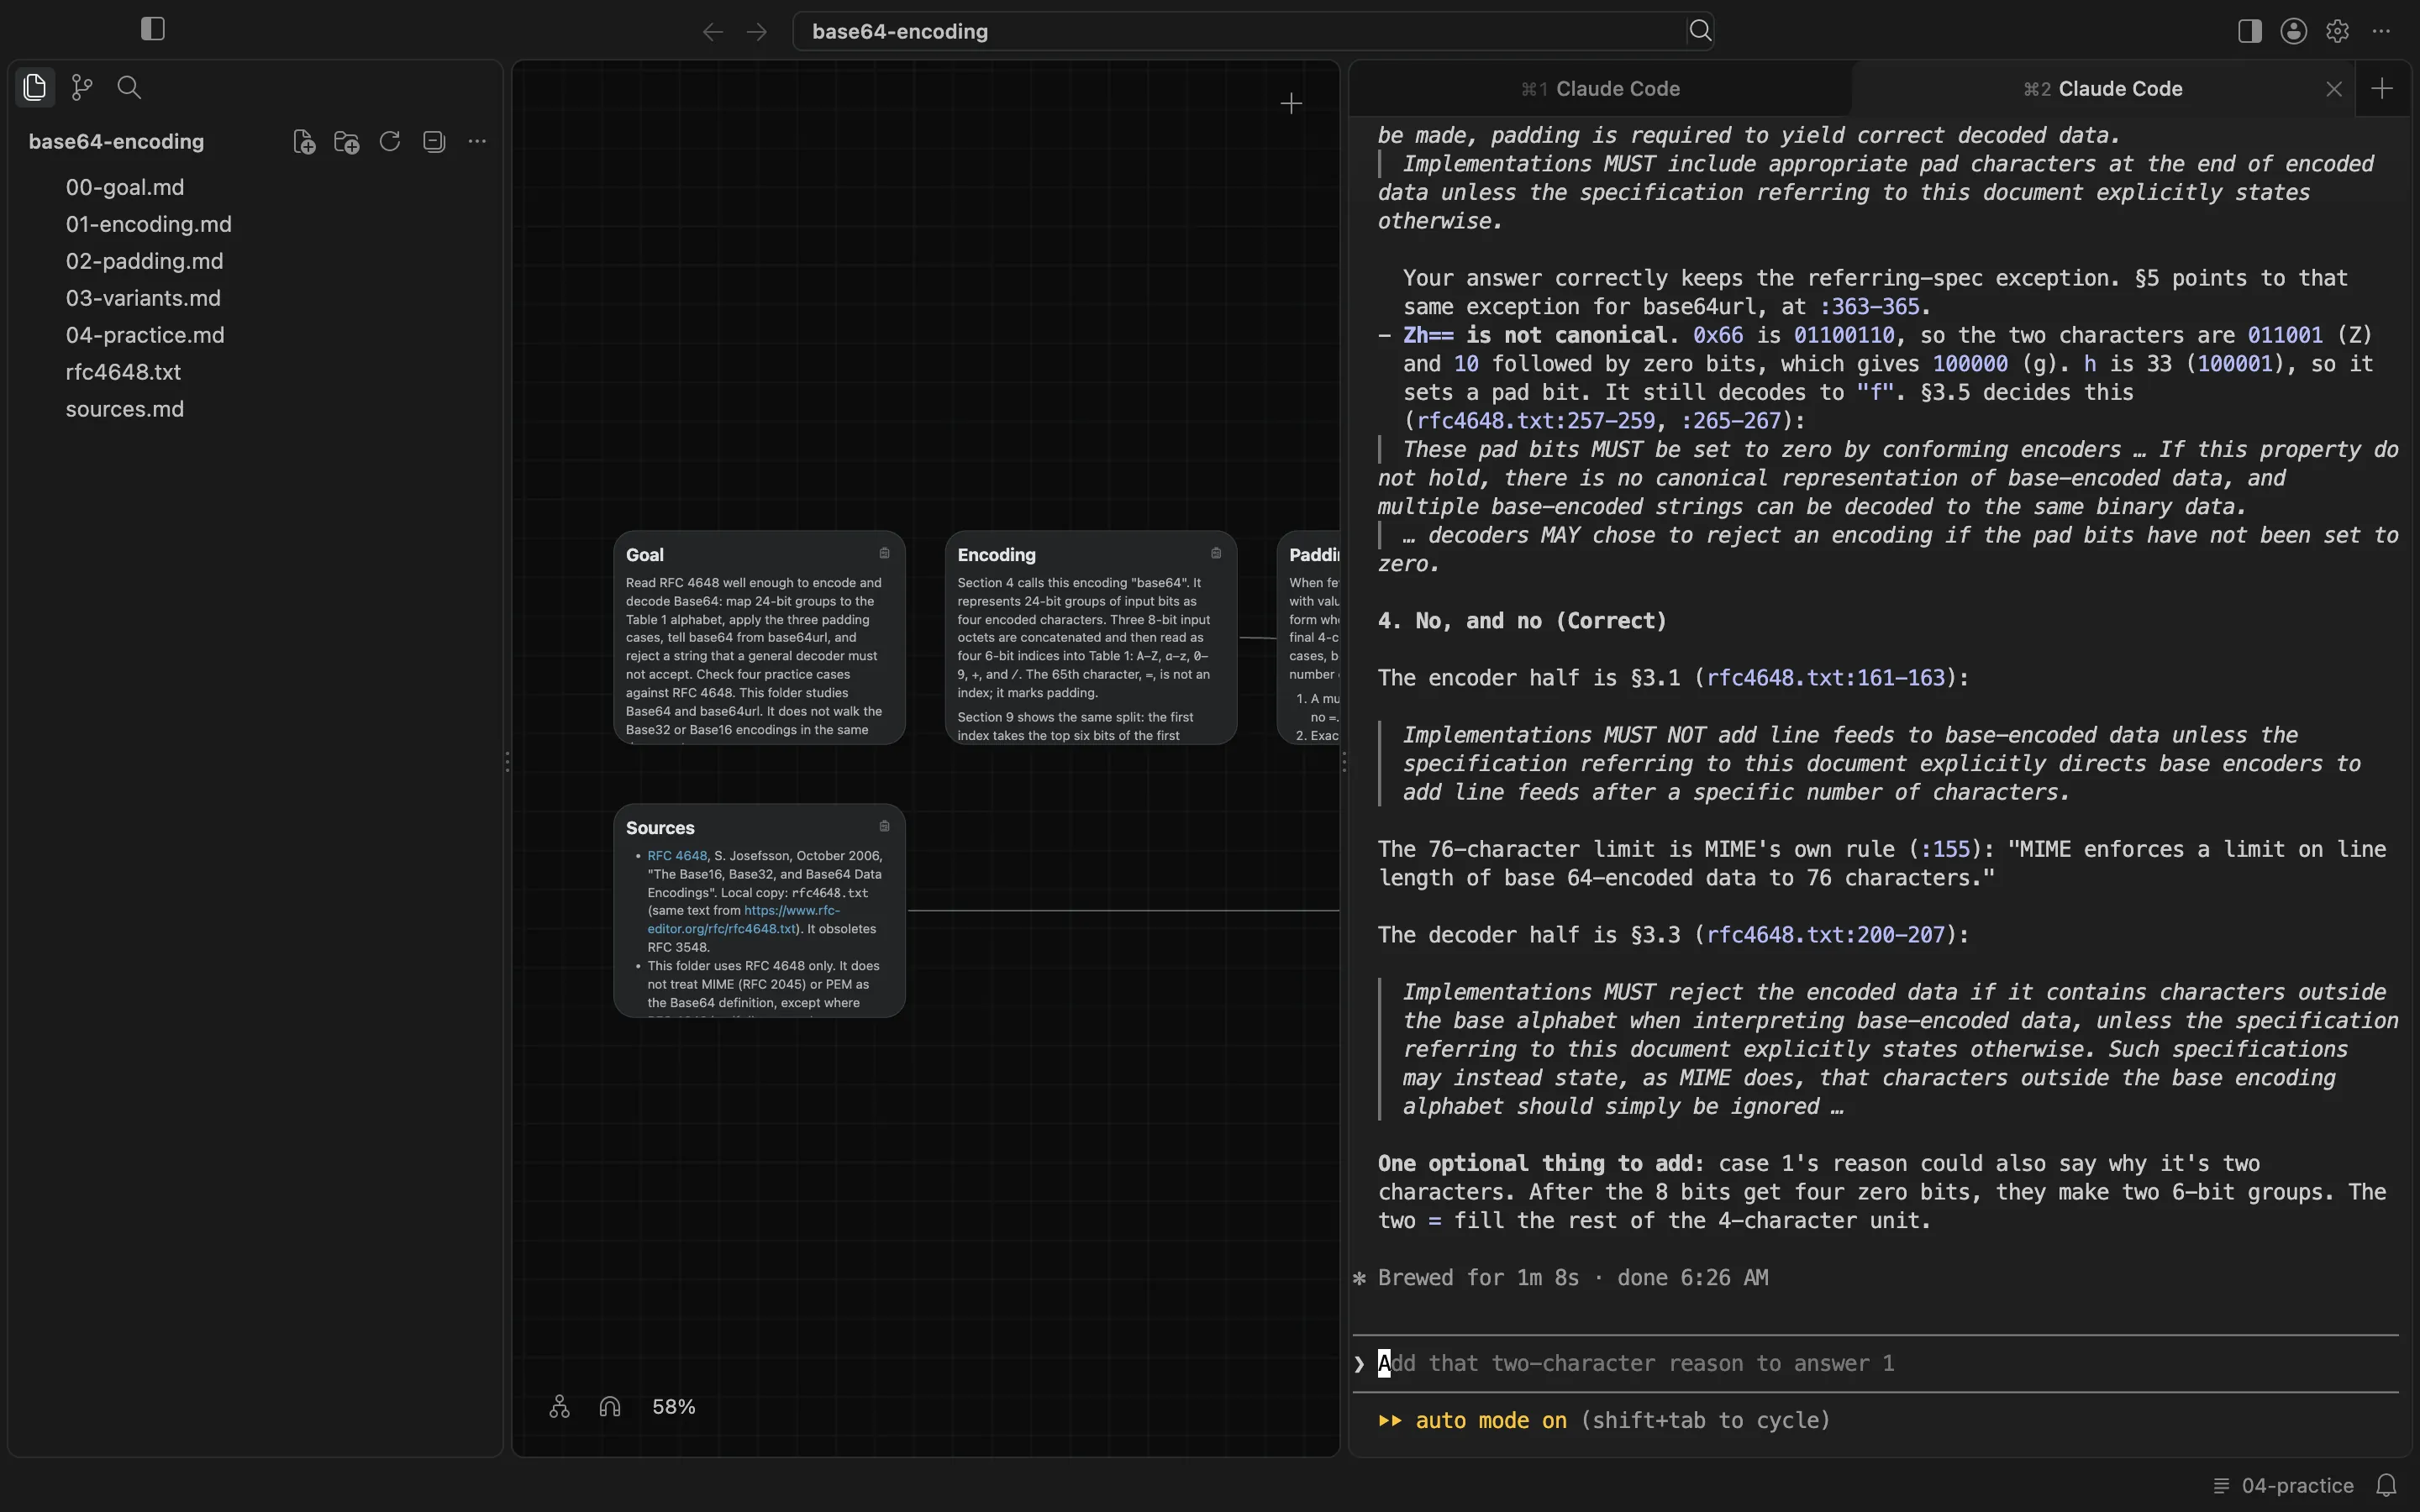
第三道题,它同意这三个字符串都不成立,理由与我们写的相同。Zg= 不合法,因为第 4 节情形 (2) 要求 8 位输入配两个 =。Zg 在一般情形下不合法;它引用了第 3.2 节:在无法假定数据大小时需要填充,以及除非引用规范另有规定,实现 MUST 补上填充字符。它指出我们的答案保留了这条例外,并且第 5 节对 base64url 指向了同一条例外。第 5 节的指向在内容上是对的:该节写明,在数据长度可以从别处知道时可以省略填充,并指向第 3.2 节。它为这条指向标出的行号,落在了附近一段讨论未采用的 ~ 字母表的文字上,而不是讨论填充的那一句,所以我们看的是章节正文。对于 Zh==,它按比特算了一次:0x66 是 01100110,得到 Z,然后是 10 再补零比特,即 100000(g)。h 是 33,也就是 100001,所以有一个填充位被置位。它仍然能解码成 "f"。它引用了第 3.5 节,包括 RFC 自己的措辞:填充位 MUST 被设为零,否则多个字符串可以解码成同一串八位组,解码器 MAY 拒绝这种编码。我们核对了这些段落,引文和比特计算都成立。
第四道题,它同意两个答案都是「不」。它引用第 3.1 节:除非引用规范明确要求编码器在特定字符数之后插入换行,实现 MUST NOT 添加换行。它把 76 字符的限制放回 MIME 本身,引用了 MIME 对 base 64 编码数据施行 76 字符行长限制的那句。解码器这一半,它引用第 3.3 节:除非引用规范明确另有规定,实现 MUST 拒绝包含字母表以外字符的编码数据;MIME 是改为忽略这些字符的例子。我们核对了这两节,引文成立。同一节稍后还写明,在这种 MIME 式规则下,相邻的 CRLF 属于非字母表字符,会被忽略。这并不改变一般情形下的判定。
这次会话能说明什么,不能说明什么
四道做完的练习只是一个起点,并不是读完了 RFC 4648。我们没有走 Base32、Base16、第 11 节的 C 实现,也没有走第 12 节的安全注意事项。模型可能把章节或行号引错;核对要以本地 RFC 为准。这次我们核对过的章节引文是成立的,有几处行号并不准。以后还可以打开同一个文件夹,补一道 Base32 的练习,接着往下学。