
用 BaseHalf 和 AI 入门正则表达式
我们在 BaseHalf 里打开真实的 regex-fundamentals 文件夹,把字面量、字符类、锚点和转义笔记摆成卡片,把 upstream 写进练习笔记,再在 Agent Area 用 Claude Code 把 ^[0-9]{5}$ 判为正确。
检查一条短正则时,最好把每个部分放在自己的卡片上,让智能体同时看到这些卡片和练习笔记。我们在桌面上建了一个普通文件夹,塞进六份短 Markdown,再用 BaseHalf 打开。窗口标题变成 regex-fundamentals,侧栏列出每一个文件,每份笔记变成卡片。我们在右侧 Agent Area 启动了 Claude Code,并选中了练习卡片。
磁盘上的路径是 Desktop/basehalf-learn-sessions/regex-fundamentals/。画布上的文件是这些:
regex-fundamentals/
  00-goal.md
  01-literals-and-classes.md
  02-anchors-and-quantifiers.md
  03-escaping.md
  04-practice.md
  sources.md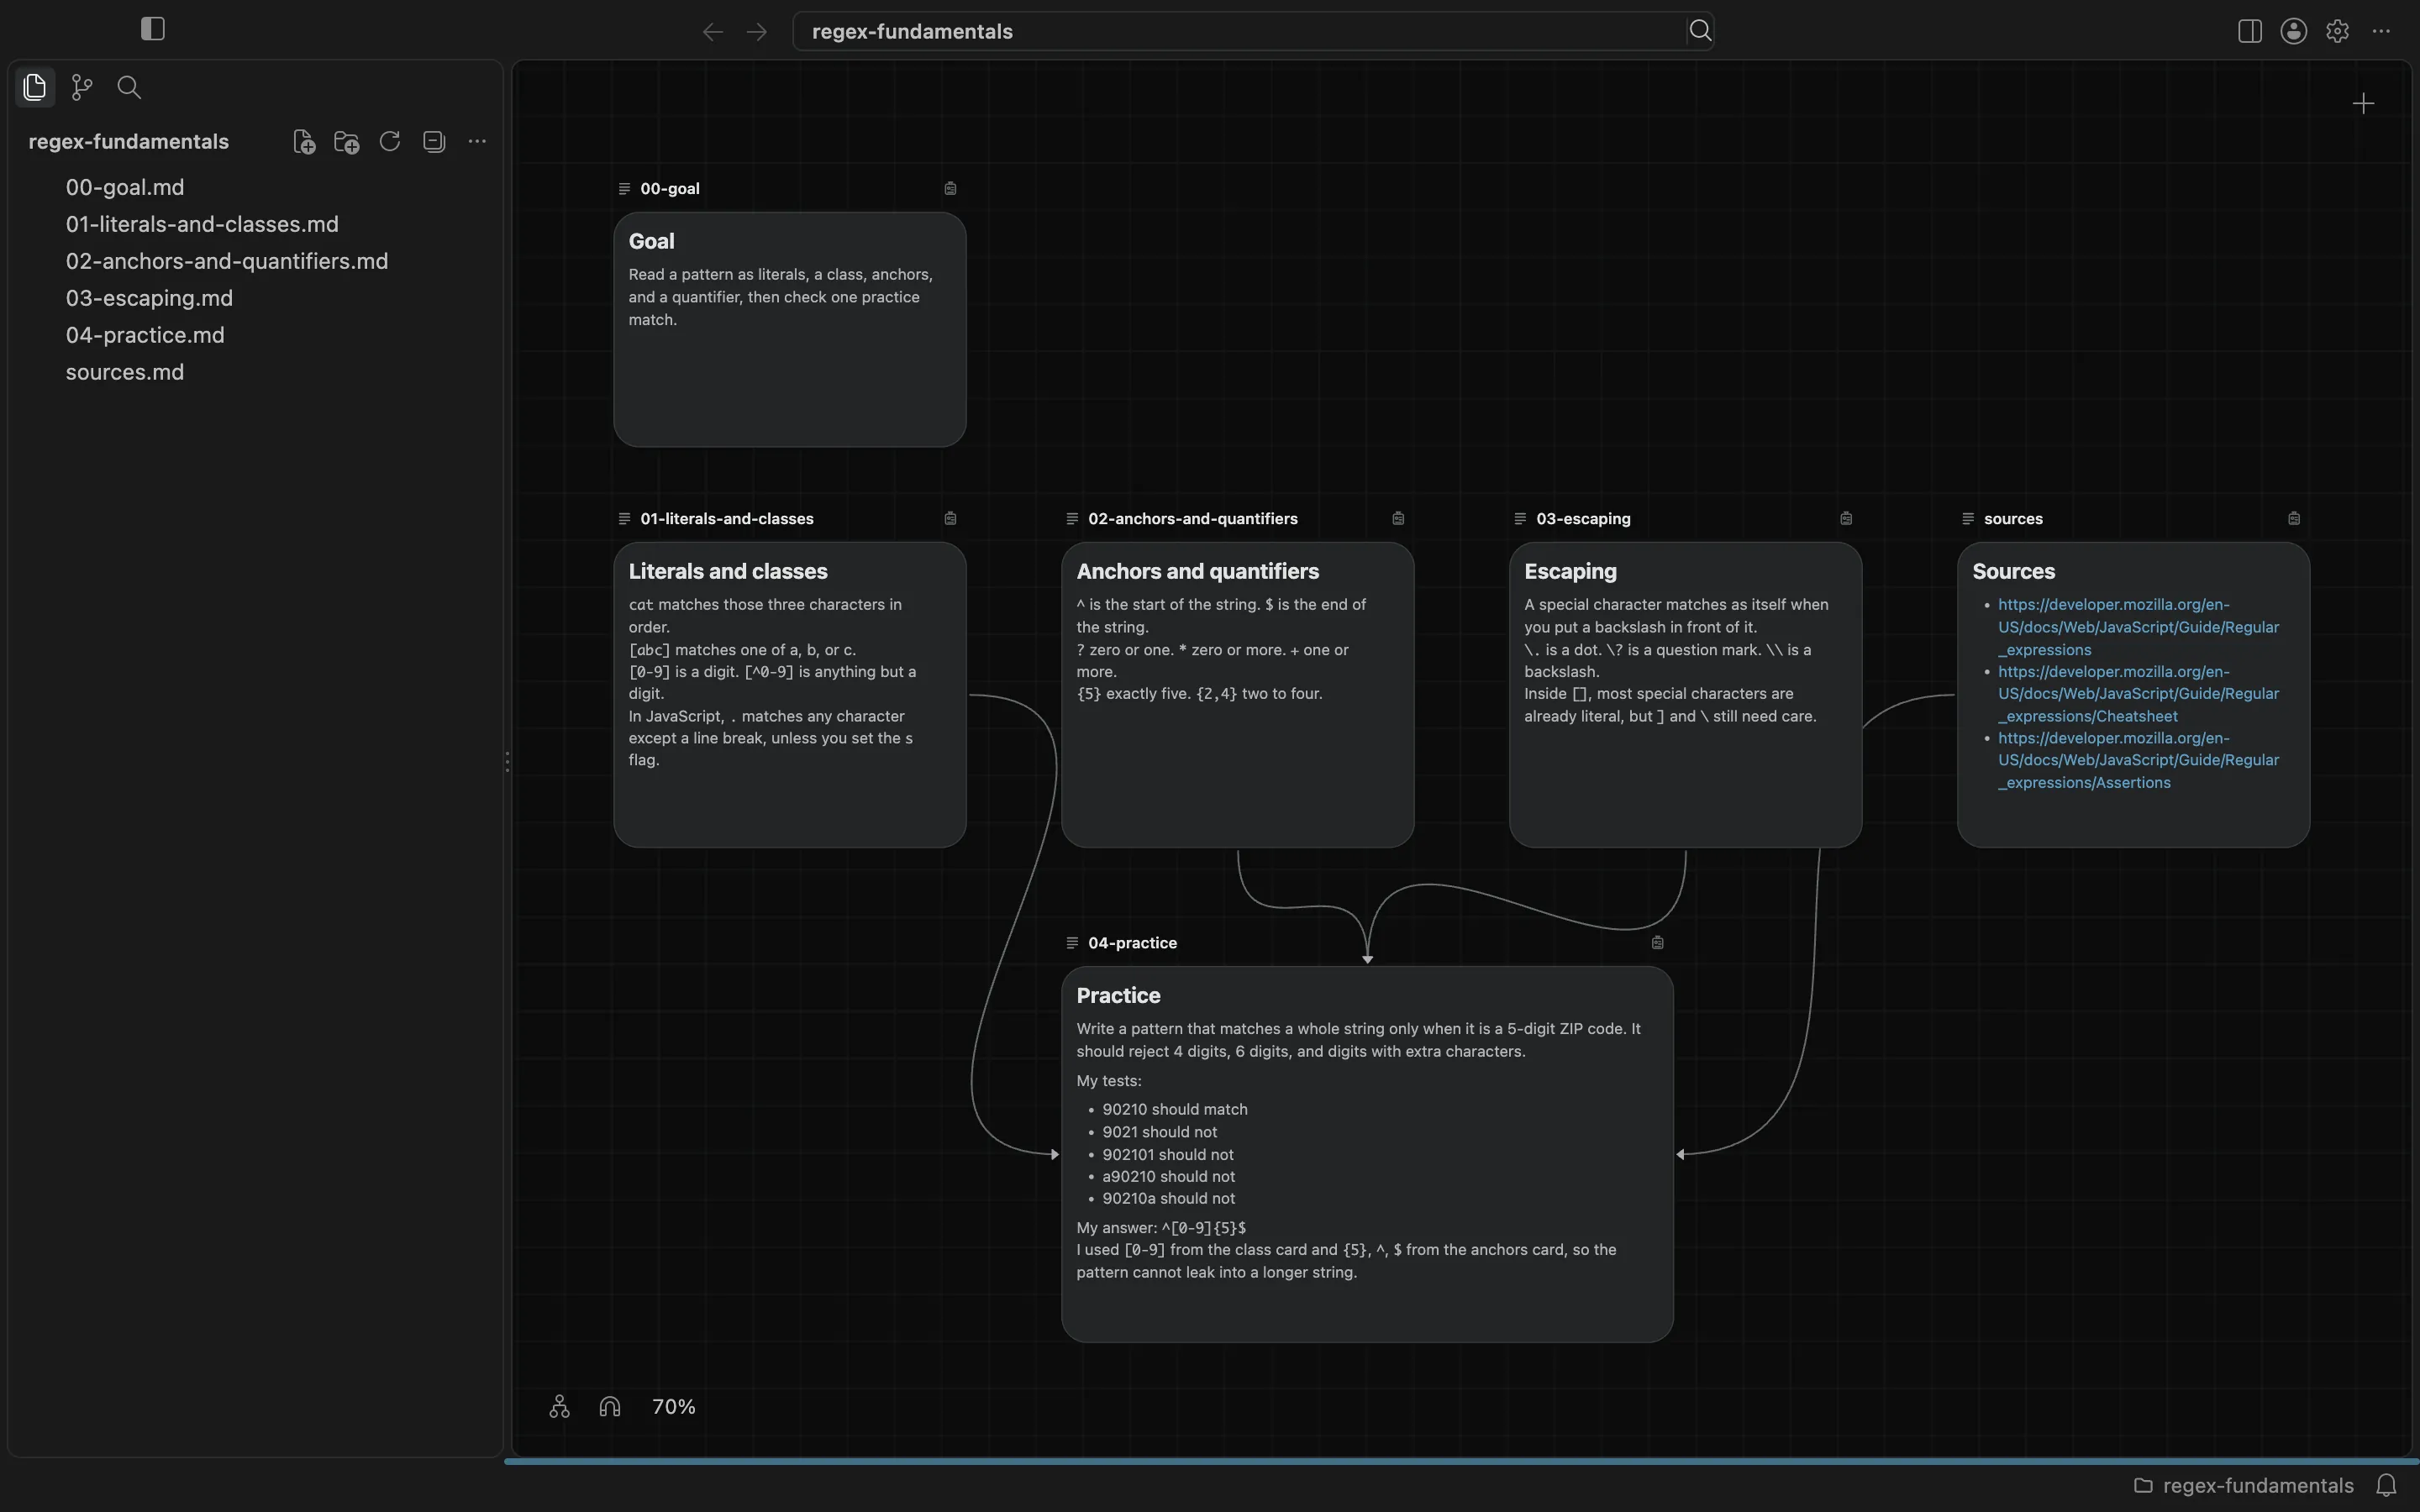
每张卡片写了什么
00-goal.md 划定范围:把一条模式读成字面量、字符类、锚点和量词,然后核对一道练习。
01-literals-and-classes.md 写明:cat 按顺序匹配这三个字符,[abc] 匹配其中某一个字母,[0-9] 是一位数字;在 JavaScript 里,除非设置 s 标志,. 匹配换行以外的任意字符。
02-anchors-and-quantifiers.md 记下:^ 是字符串开头,$ 是末尾,还有 ?、*、+,{5} 表示恰好五个,{2,4} 表示两个到四个。
03-escaping.md 说明:特殊字符前面加上反斜杠,就会按字面匹配。\. 是点,\? 是问号,\\ 是反斜杠。
sources.md 链接了 MDN 正则表达式指南、速查表,以及 Assertions。对这个文件夹来说,这些页面才是依据,而不是模型本身。
练习笔记上的 Upstream
我们把练习笔记连到三张概念卡片和 sources.md。画布上,从 01-literals-and-classes、02-anchors-and-quantifiers、03-escaping 和 sources 出发的线,都进入 04-practice。之后,04-practice.md 的开头是:
upstream:
  - 01-literals-and-classes.md
  - 02-anchors-and-quantifiers.md
  - 03-escaping.md
  - sources.md
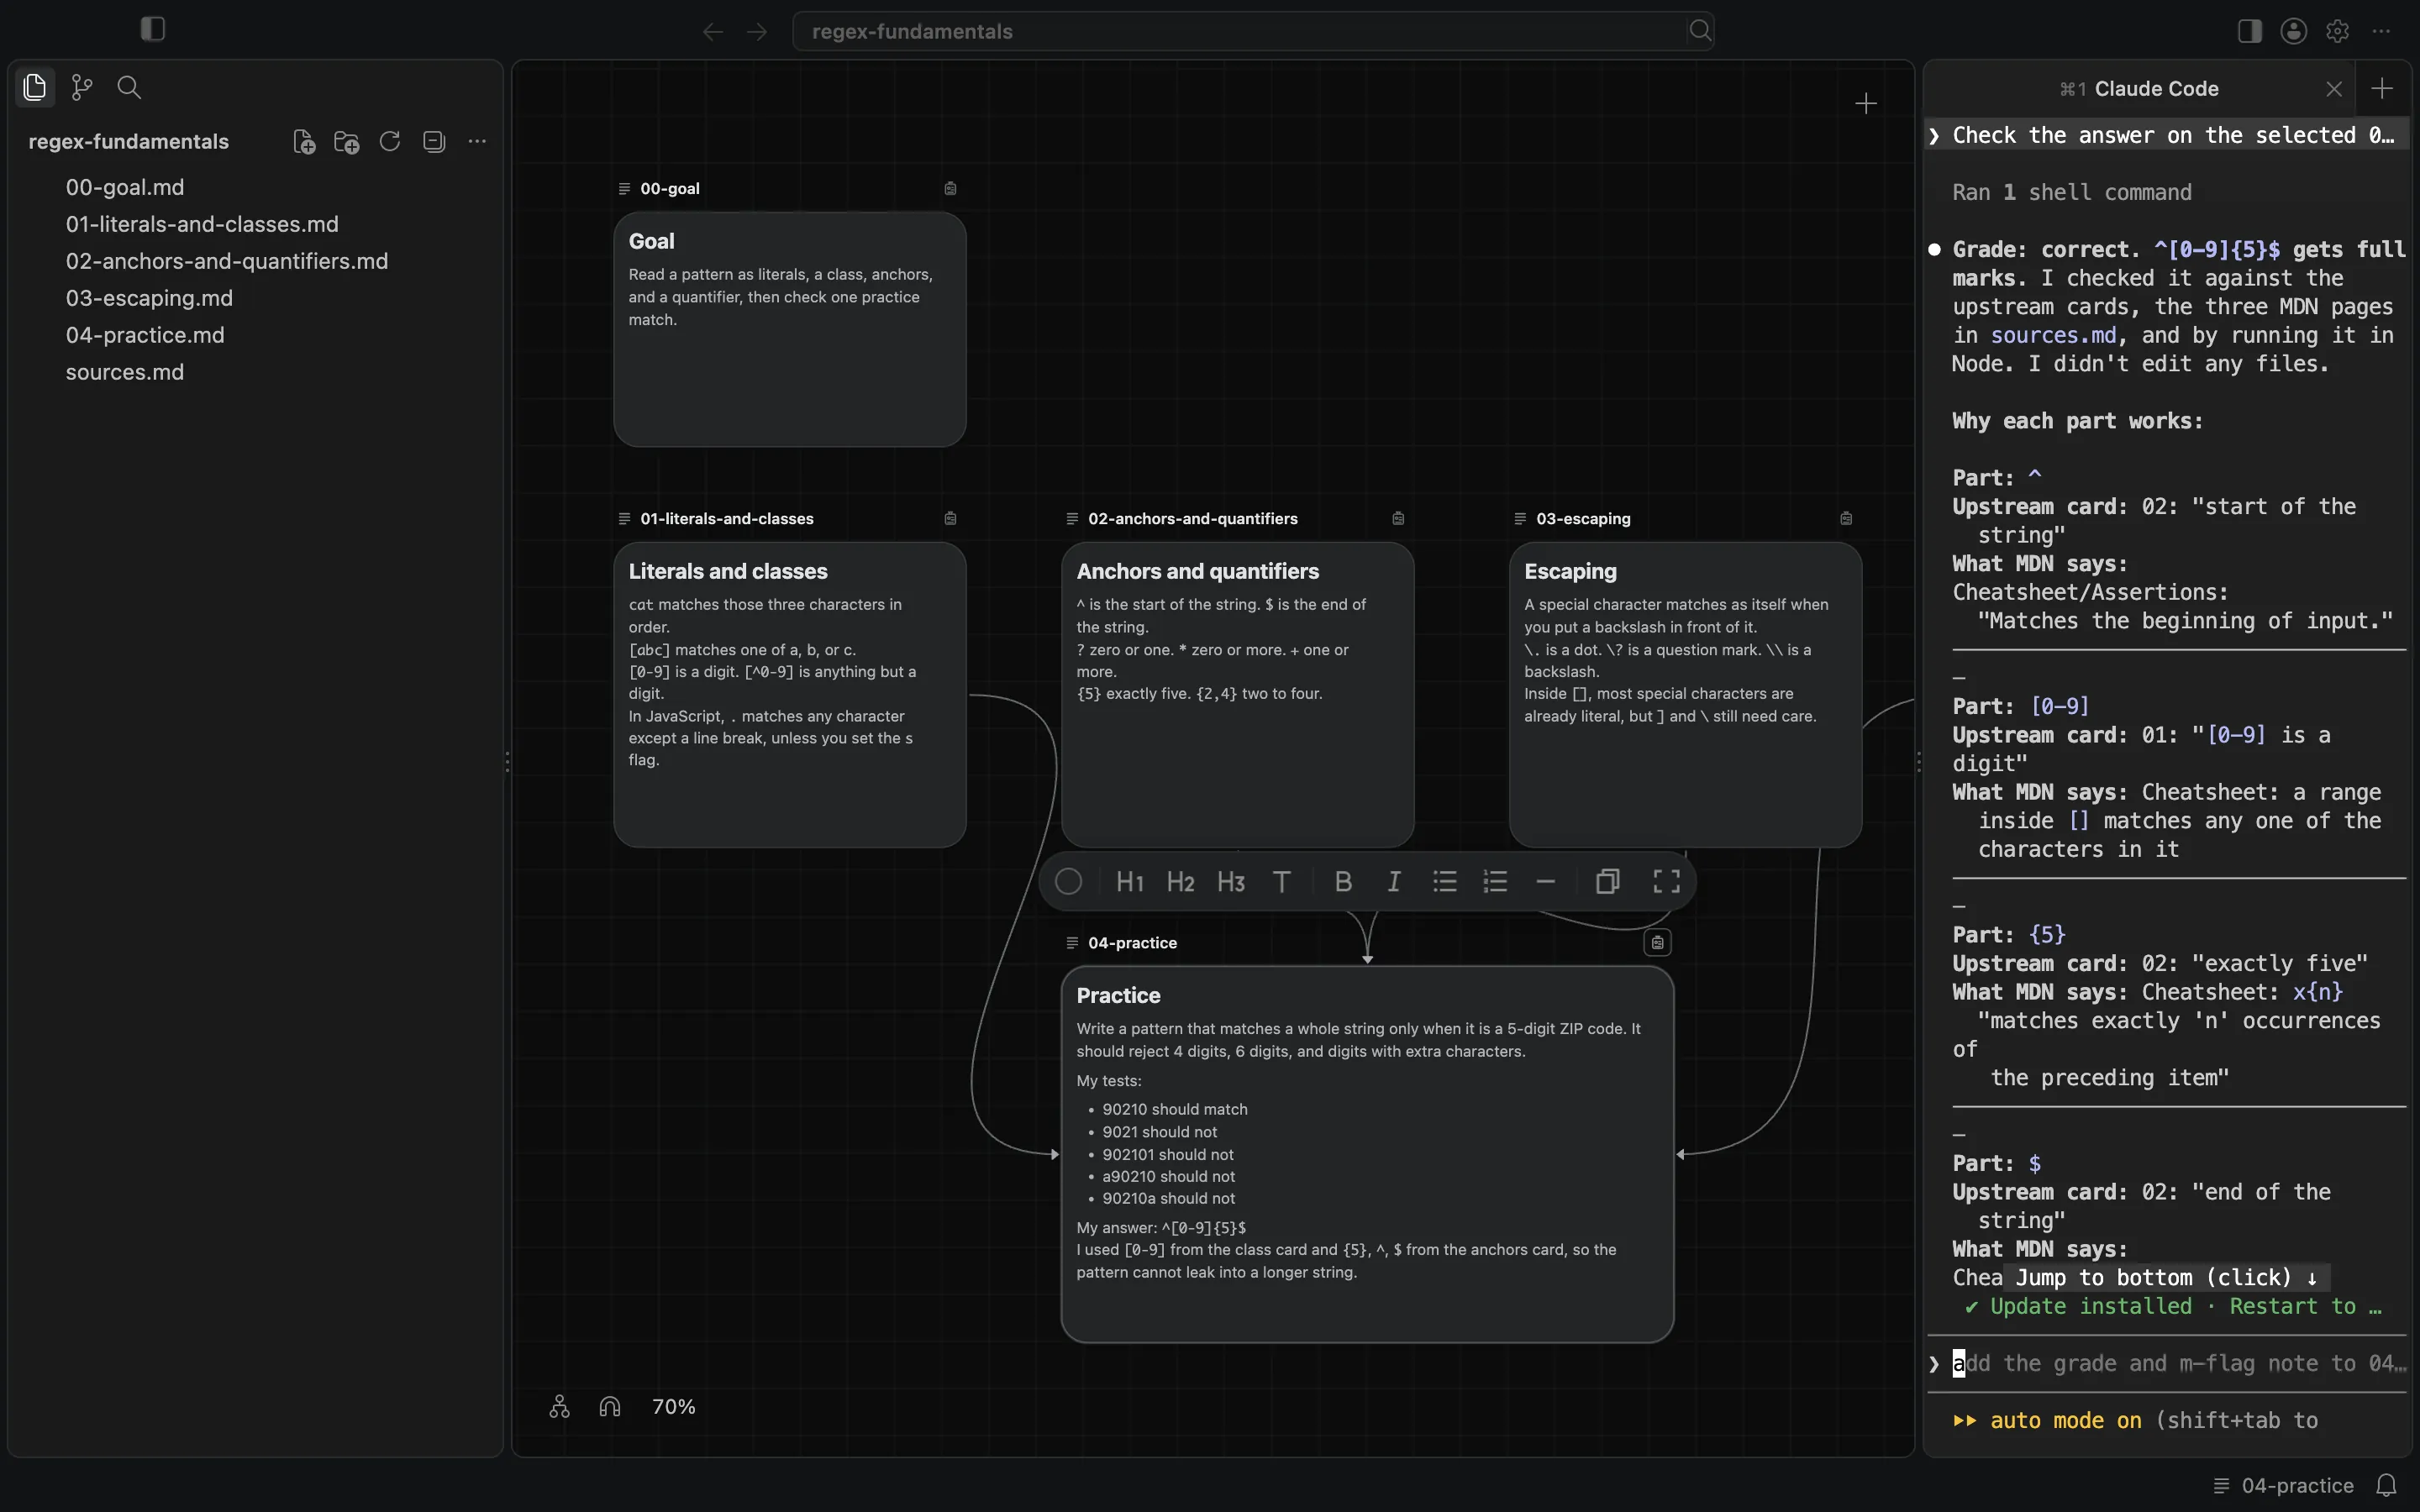
这份列表会留在文件里。选中不会:它只在 BaseHalf 打开时写在 .bh/cache/selection.yaml。我们选中了练习卡片,状态栏显示 04-practice,然后请 Claude Code 批改。
ZIP 练习
练习卡片的题目是:写一条模式,只有整个字符串是 5 位邮政编码时才匹配;4 位、6 位,以及带有多余字符的数字都应被拒绝。
卡片上的测试:90210 应匹配;9021、902101、a90210、90210a 不应匹配。
我们的答案是 ^[0-9]{5}$。[0-9] 来自字符类那张卡片,{5}、^ 和 $ 来自锚点那张卡片,这样模式就不会漏进更长的字符串。
Claude Code 实际说了什么
把回复当作草稿来看。这次会话里,Claude Code(Opus 4.5)给出的成绩是正确,并说 ^[0-9]{5}$ 得了满分。它对照了上游卡片、sources.md 里的三篇 MDN 页面,并在 Node 里运行了这条模式。它没有编辑任何文件。
它把每个部分都对回一张卡片和文档里的一句话:^ 对到卡片 02 的 “start of the string”,以及 MDN 的 “beginning of input”;[0-9] 对到卡片 01 的 “a digit”;{5} 对到卡片 02 的 “exactly five”;$ 对到卡片 02 的 “end of the string”。
它还用 /^[0-9]{5}$/.test(...) 在 Node 里跑了我们的五个测试,结果都和预期一致。另外试了空字符串、带换行的字符串等情况,模式也都拒绝了。
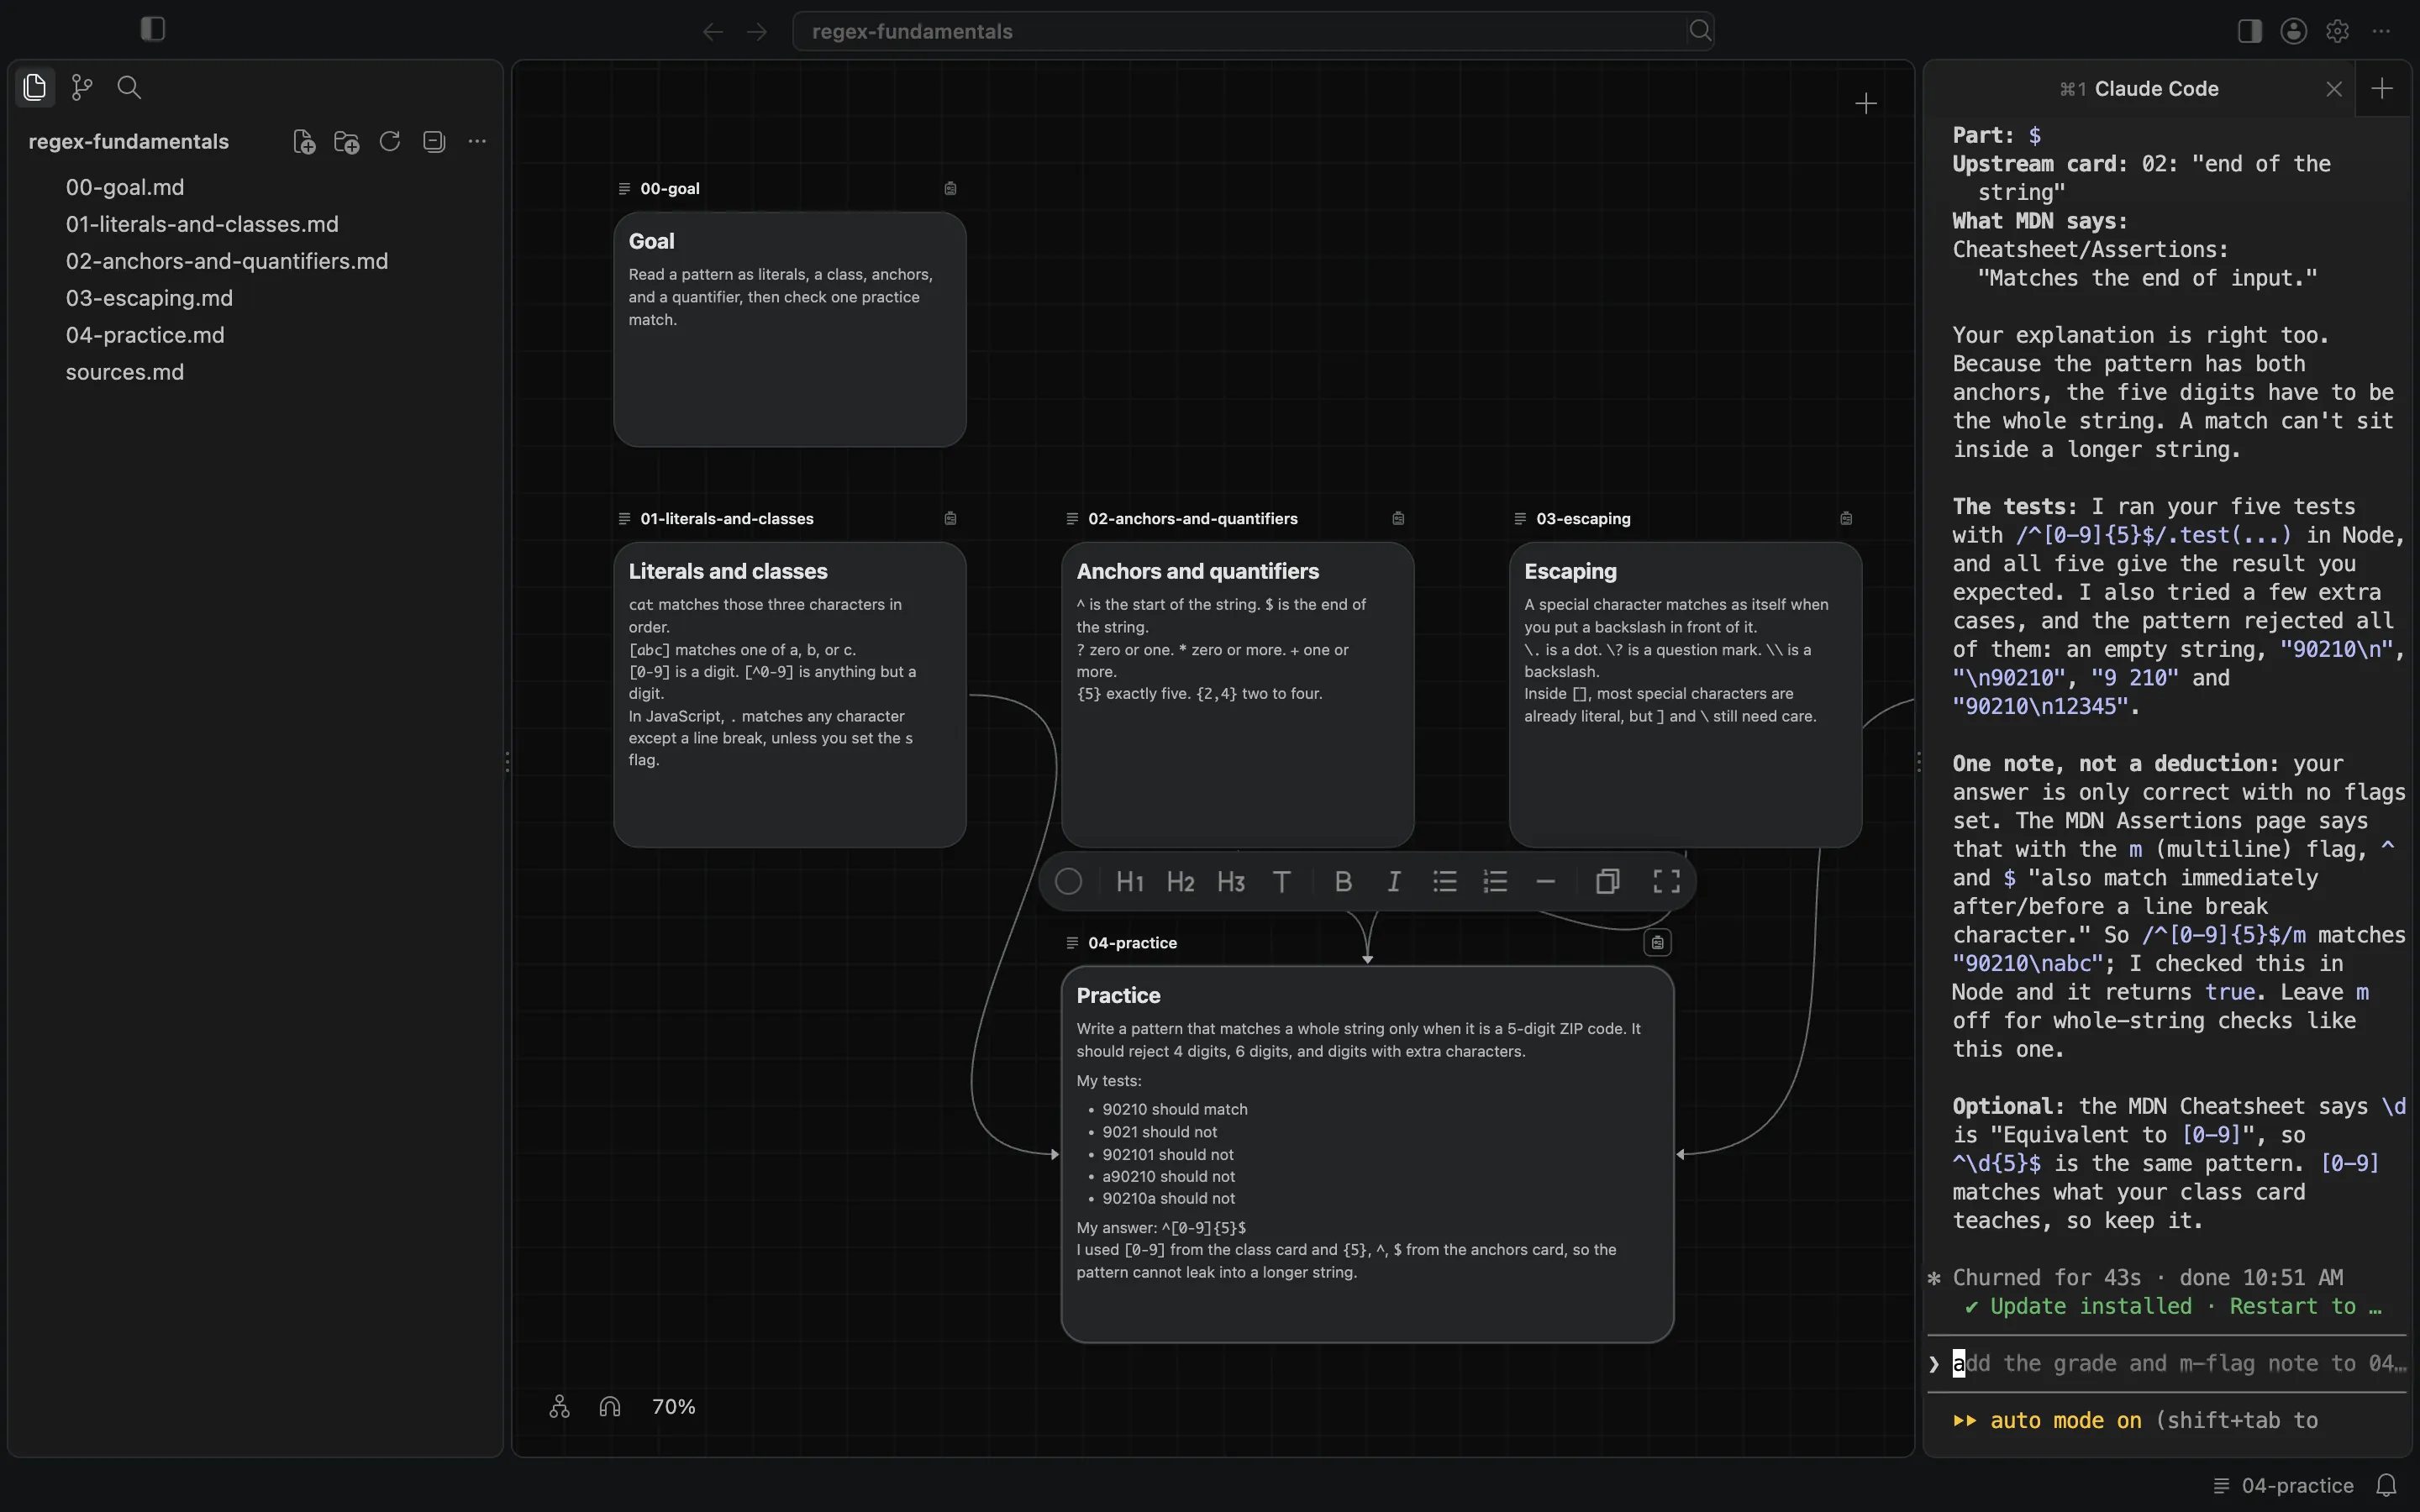
有一条说明,但不是扣分:只有在不加标志时,这个答案才完全正确。加上 m(multiline)标志后,^ 和 $ 也会在换行处匹配,所以 /^[0-9]{5}$/m 可能匹配后面还有一行的 90210。Claude Code 在 Node 里核对过这一点。要做整串检查,就不要加 m。
它还提到,MDN 速查表把 \d 写成与 [0-9] 等价,因此 ^\d{5}$ 是同一条模式。我们仍使用 [0-9],因为字符类那张卡片教的就是这个。
如果智能体的说法和 sources.md 里的链接不一致,以文档为准,再回去改画布上的笔记。
还是同一个产品,只是一次真实练习
BaseHalf 并没有为我们做成套的正则教程。我们打开一个桌面文件夹,摆好普通的 Markdown,把 upstream 写进练习文件,然后让 Claude Code 根据这些文件和链出的 MDN 页面来批改。卡片位置留在 .bh/ 里;真正要紧的连接留在文件里。这篇文章写自 regex-fundamentals 画布上的那次会话,不是虚构的教学大纲。