
用 BaseHalf 从 Attention Is All You Need 由浅入深学 Transformer
我们在 BaseHalf 里打开真实的 Attention Is All You Need PDF,从选中段落长出五条分支笔记,再写一份 Q、K、V 练习并用 Agent Area 里的 Codex 批改。
Transformer 的结构图往往很密;把论文本身放在画布上,再让每一句难啃的话变成一张笔记,会好读很多。我们把 Vaswani 等人的 Attention Is All You Need 放进桌面上的普通文件夹,用 BaseHalf 打开,在 PDF 阅读器里选段并用 Grow branch 长出五条分支,不是先凭空想摘要再硬套进空文件。走完这五步之后,我们又写了一张 Q / K / V 练习卡,自己先用一句话各答一遍,再让右侧 Agent Area 里的 Codex 按 Correct / Partial / Wrong 批改。
磁盘路径是 Desktop/basehalf-learn-sessions/attention-is-all-you-need/。长完分支、改名,并加上练习卡之后,画布上是这些文件:
attention-is-all-you-need/
  attention-is-all-you-need.pdf
  01-transformer-claim.md
  02-why-not-only-recurrence.md
  03-scaled-dot-product.md
  04-three-attention-uses.md
  05-positional-encoding.md
  06-qkv-practice.md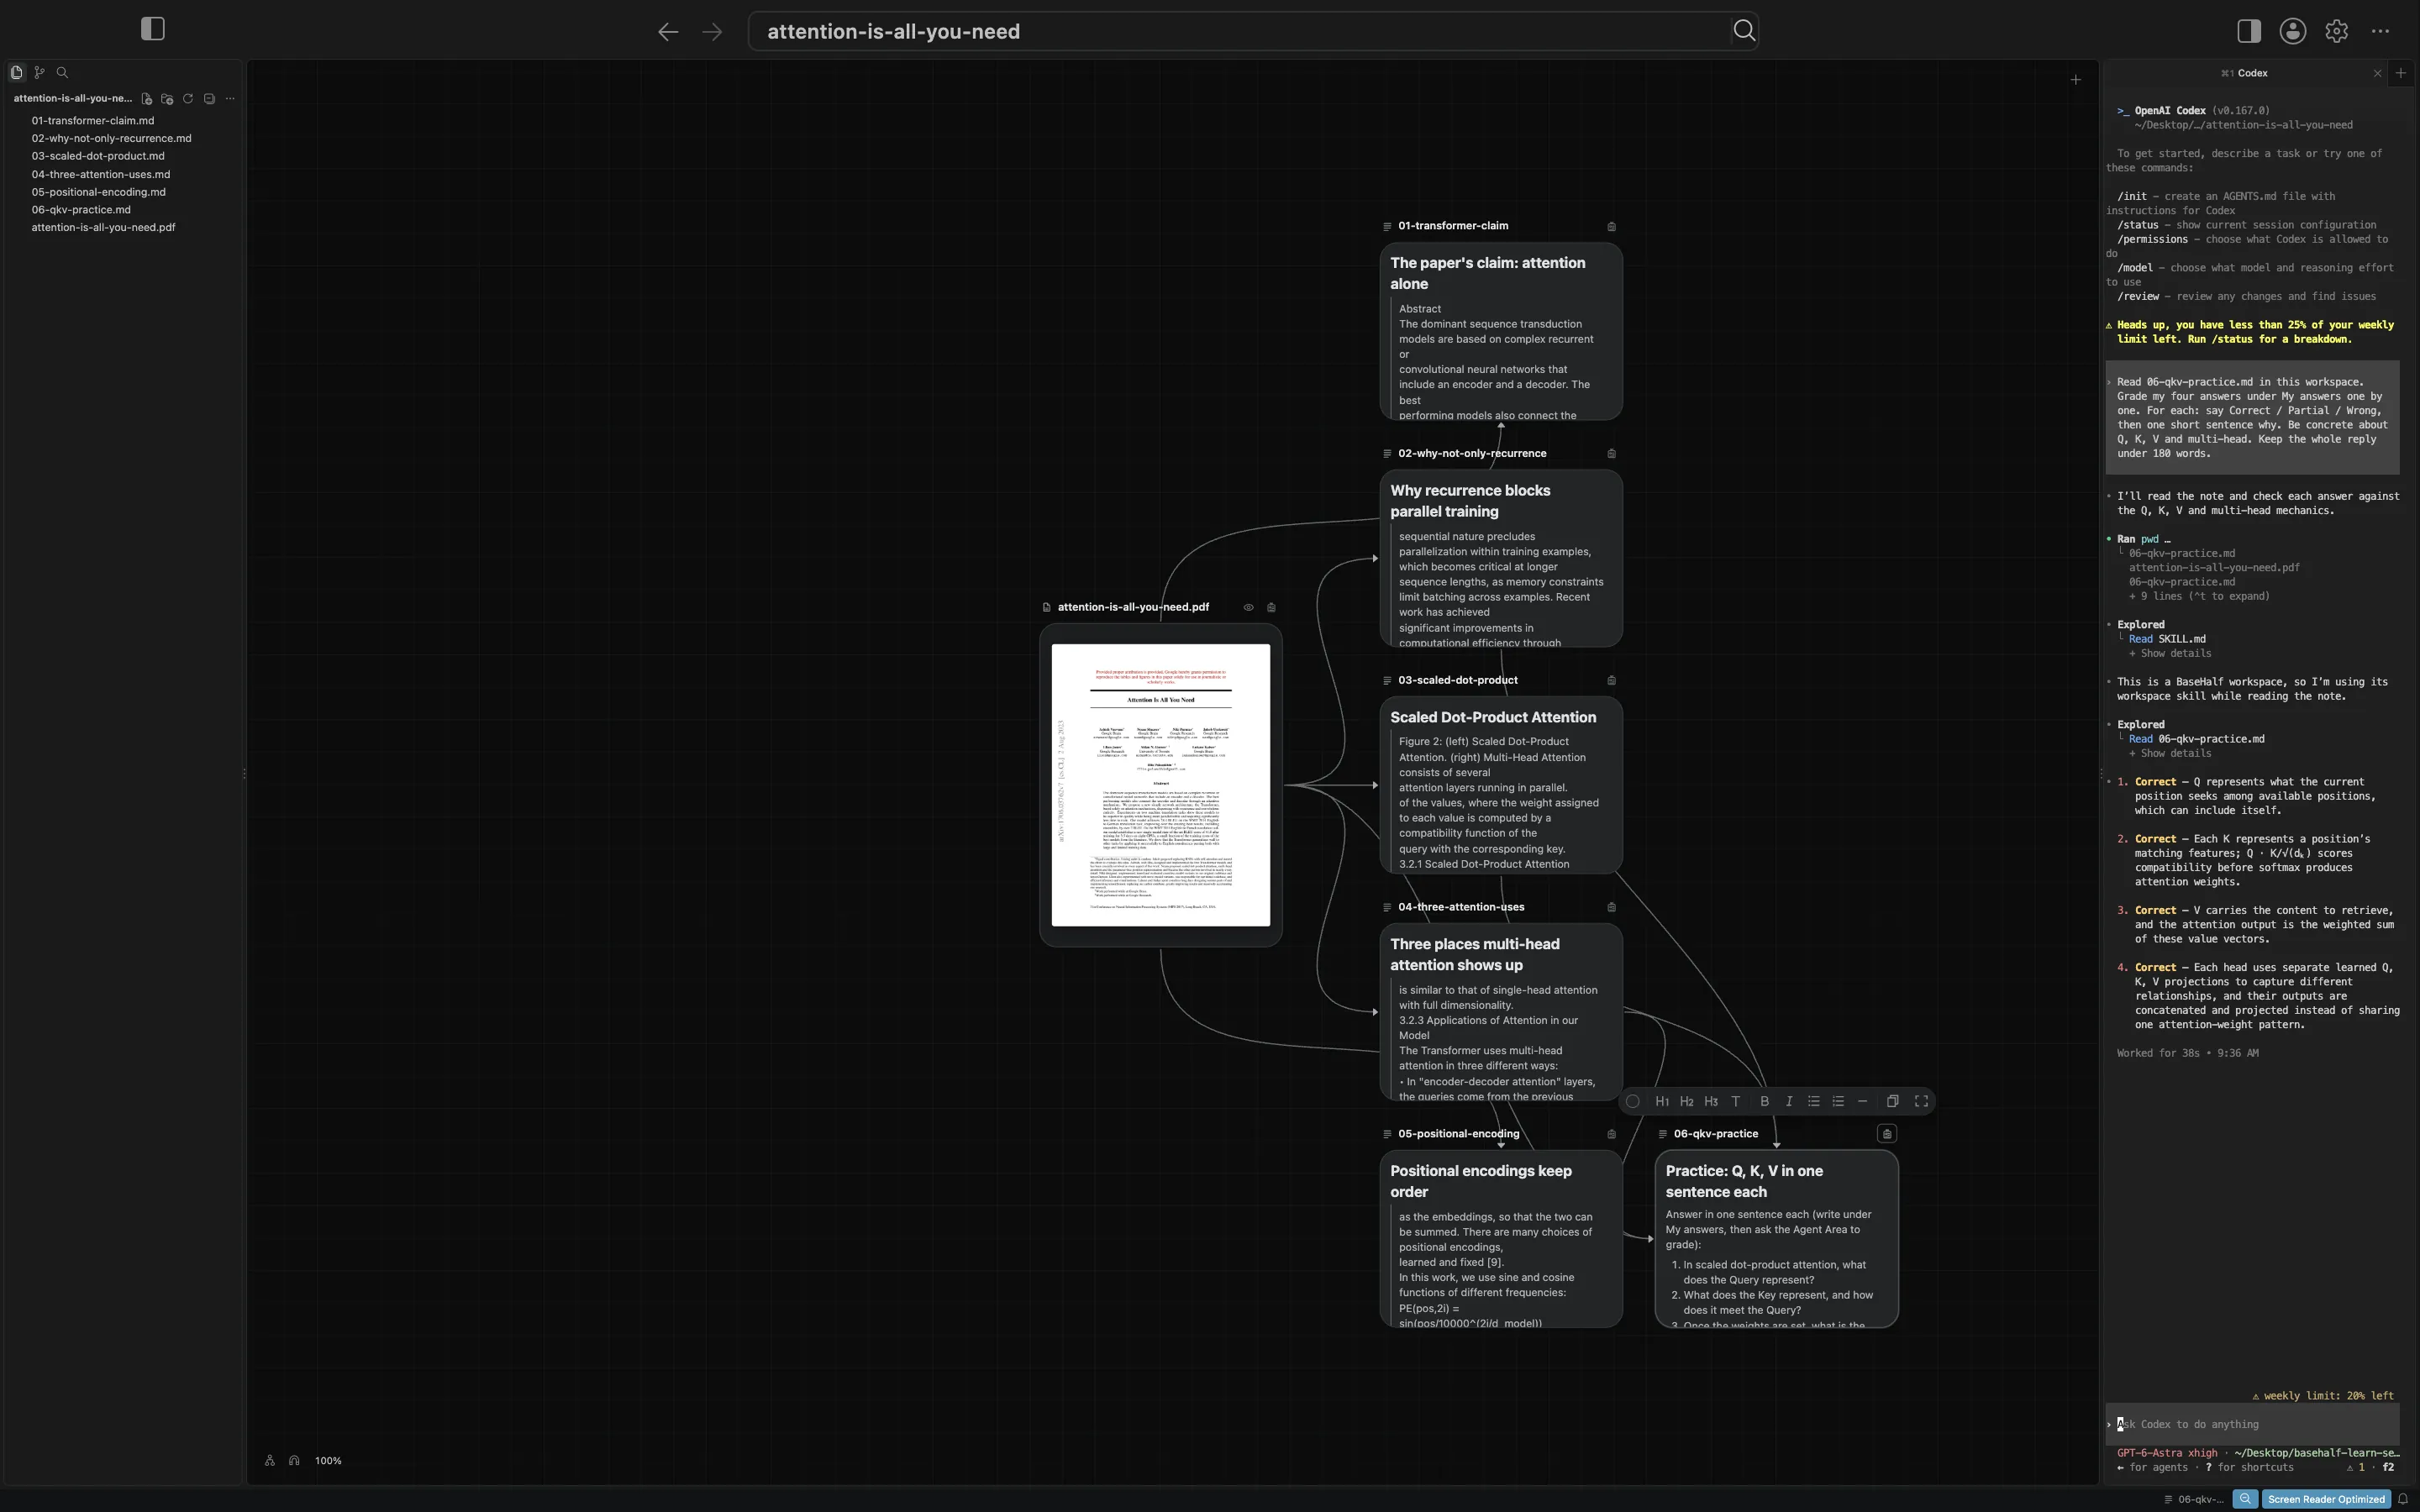
从选中的段落长出笔记,而不是从空白卡片开始
双击 PDF 卡片,在 Card Detail 里阅读。用选择工具拖过一段文字,点 Grow branch。BaseHalf 会新建一份 Markdown,并在 upstream: 里写上这篇 PDF。这是可持久的连接,和下游文件里其它连接同一套存储,git 和之后的会话都能看见笔记建立在什么之上。
我们按想留下的五个想法各做了一次。在画布上手动连线是另一条路;Grow branch 只在 PDF / 书的阅读器里、对着选中文本出现。从 PDF 或电子书的一段文字长出一条笔记 是这条产品路径的说明。
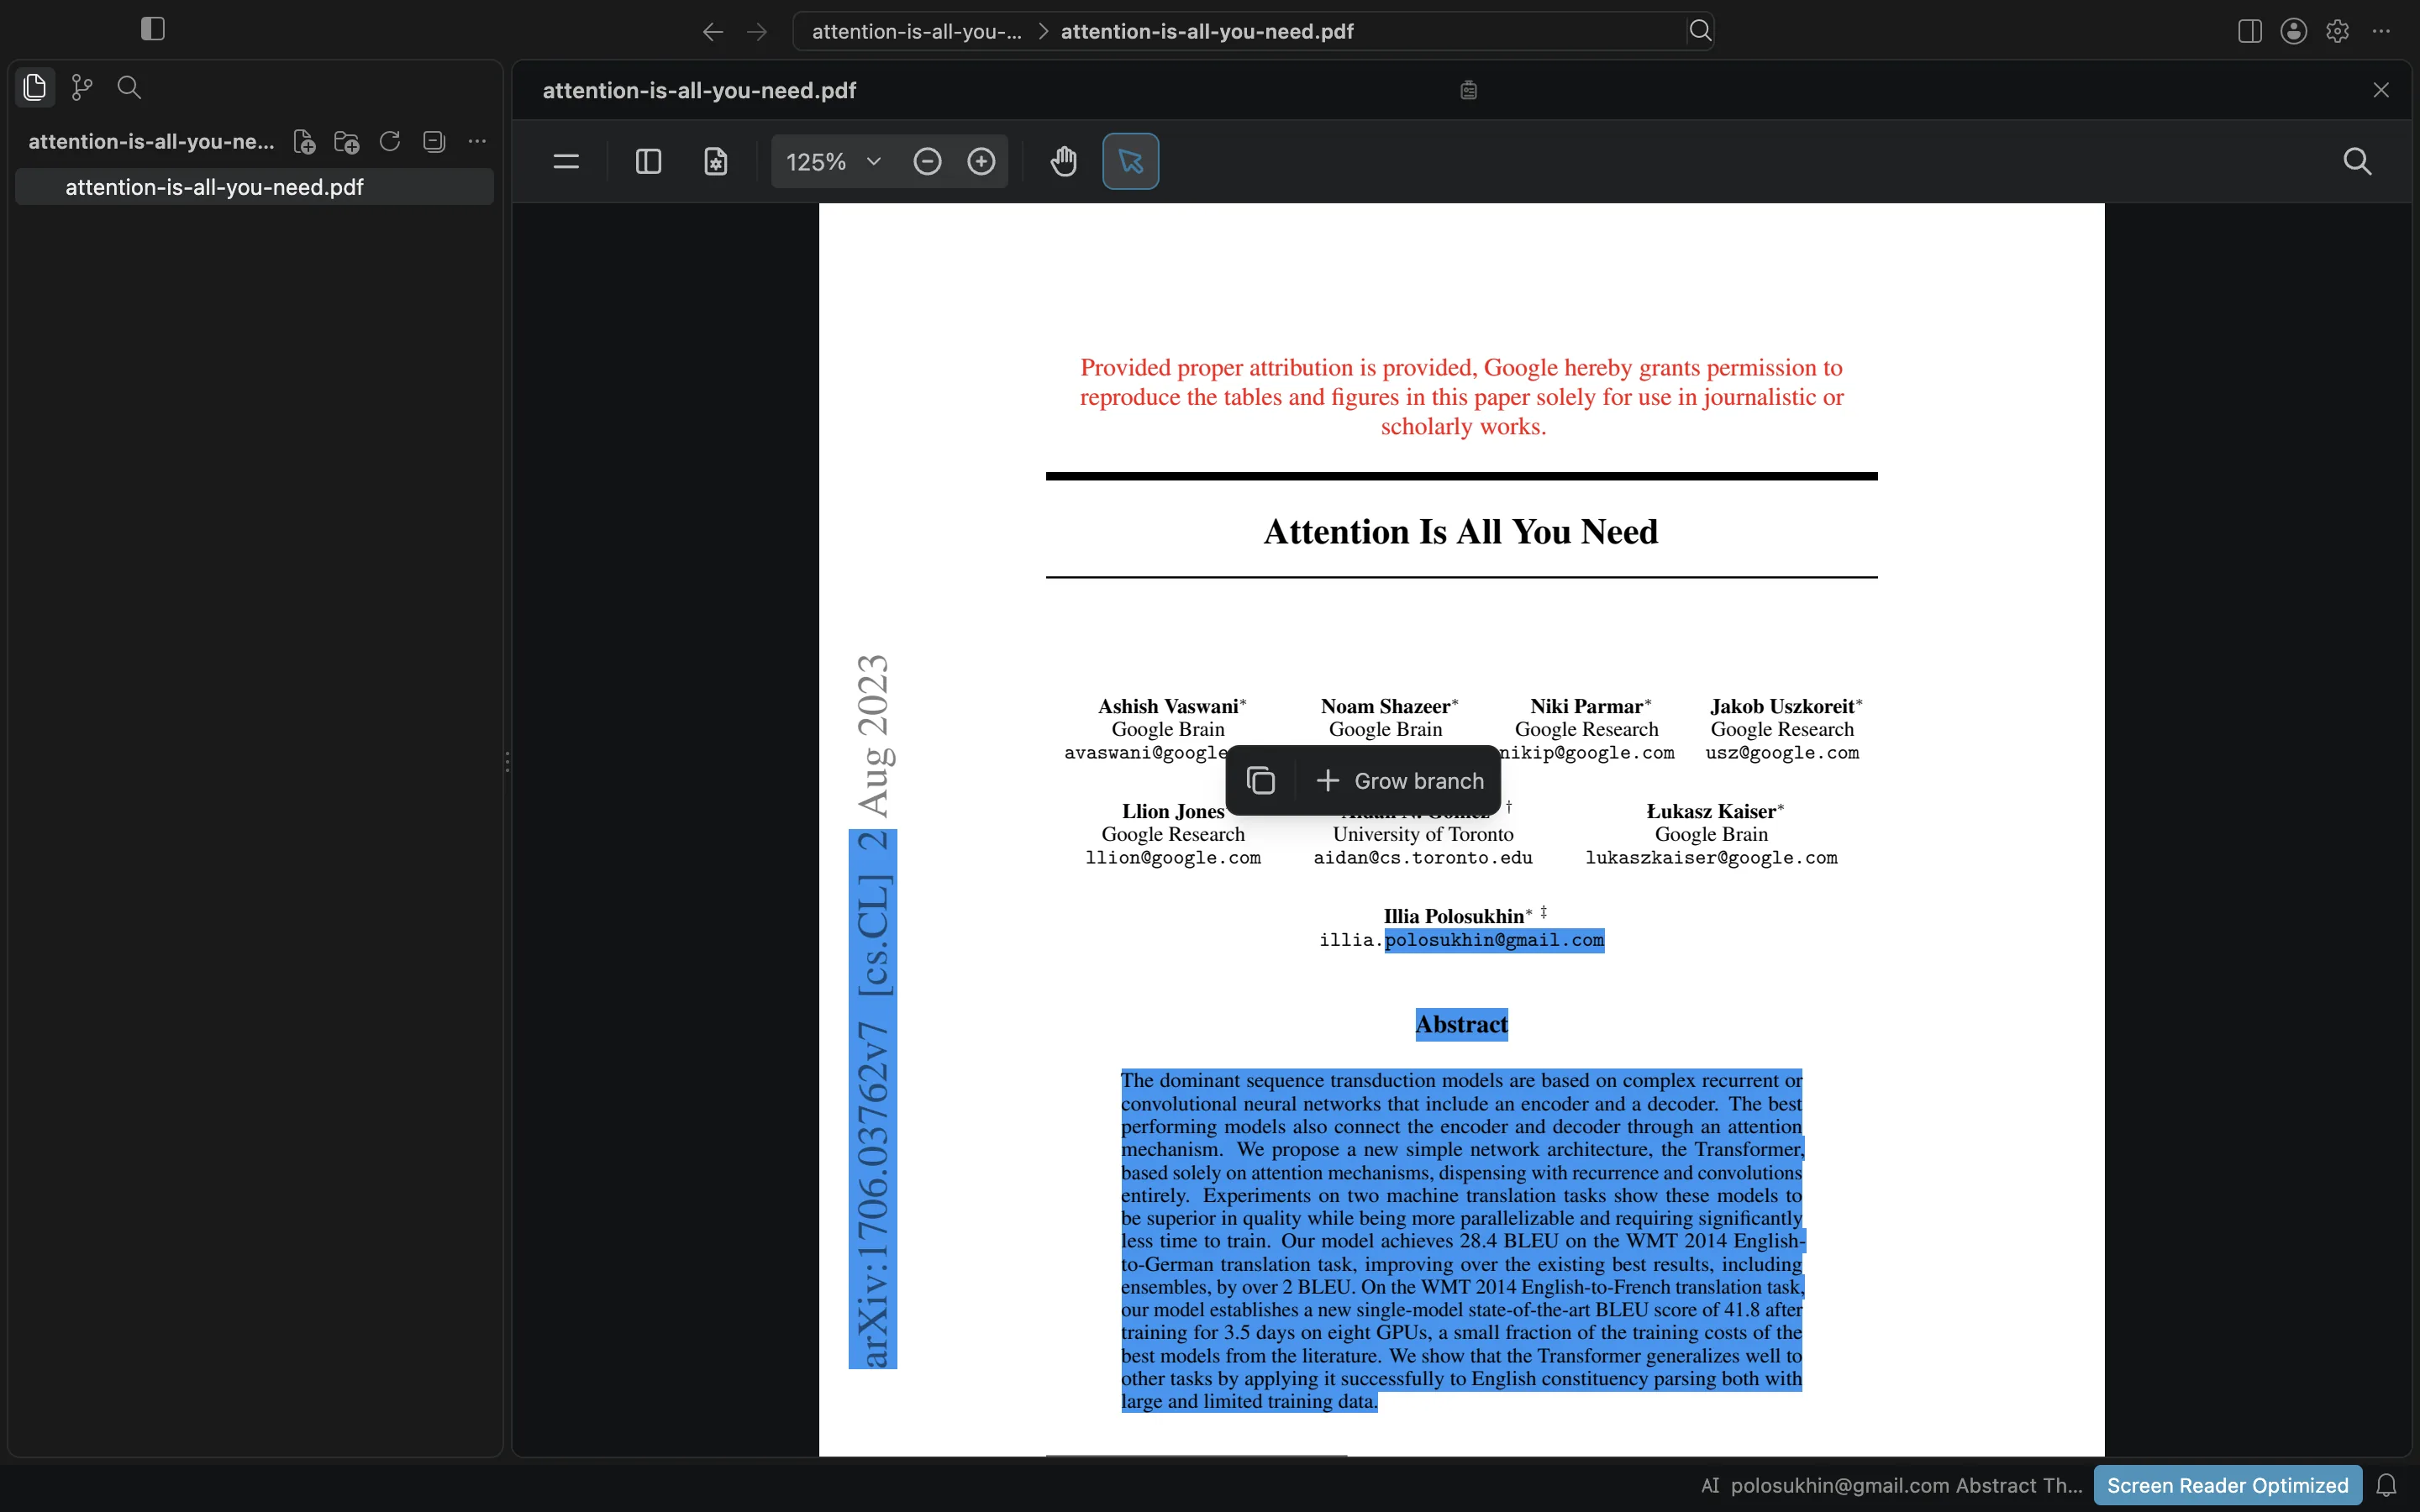
先钉住主张:只要注意力
01-transformer-claim.md 从摘要长出。卡片上的引文是全文的 punchline:序列转导模型一向是循环或卷积堆叠,再外挂注意力;Transformer 把注意力留成整座架构,去掉循环和卷积。
这是后面几步的北极星。下面每一张卡都在回答:为什么值得换,以及零件怎么接。
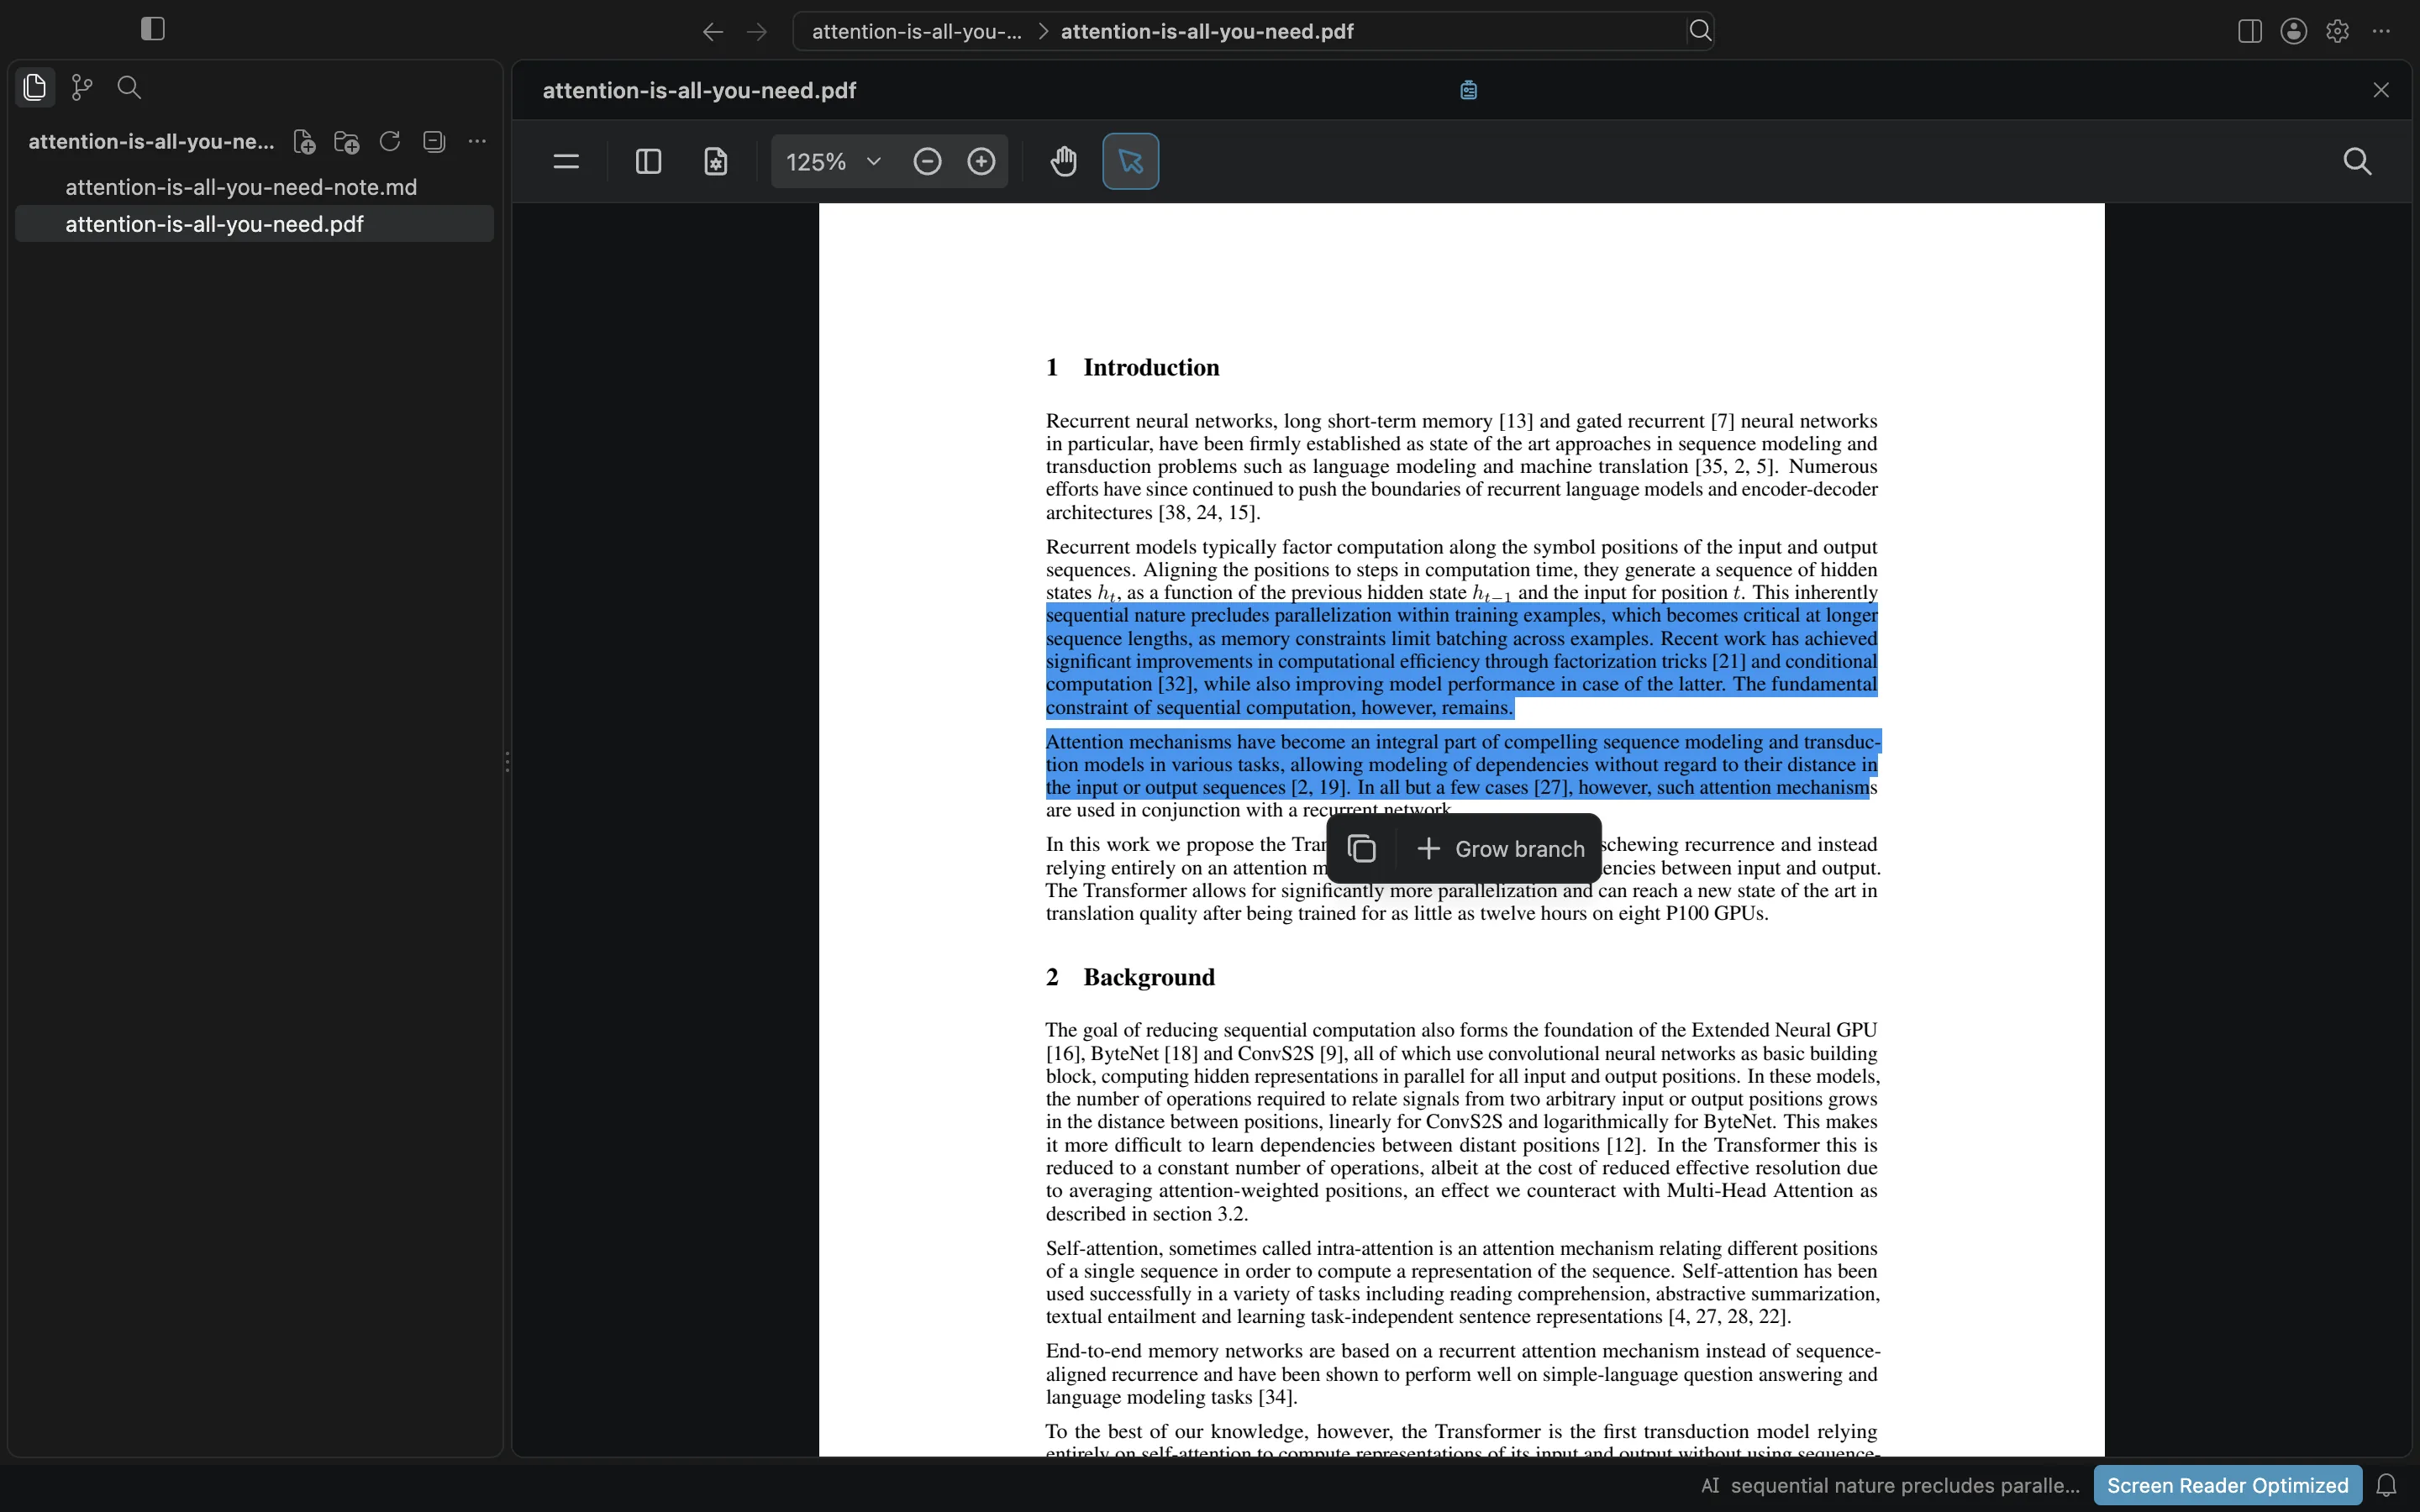
为什么循环成了瓶颈
02-why-not-only-recurrence.md 从引言长出。逐步计算挡住了单条训练样本内部的并行;序列一长就更贵。注意力本来就已经常用来连接远距离位置;这篇论文让这种连接成为整个模型,而不只是助手模块。
我们留在笔记里的白话:RNN 一步等一步;注意力可以一次关联多个位置,也更容易沿序列长度摊开训练。
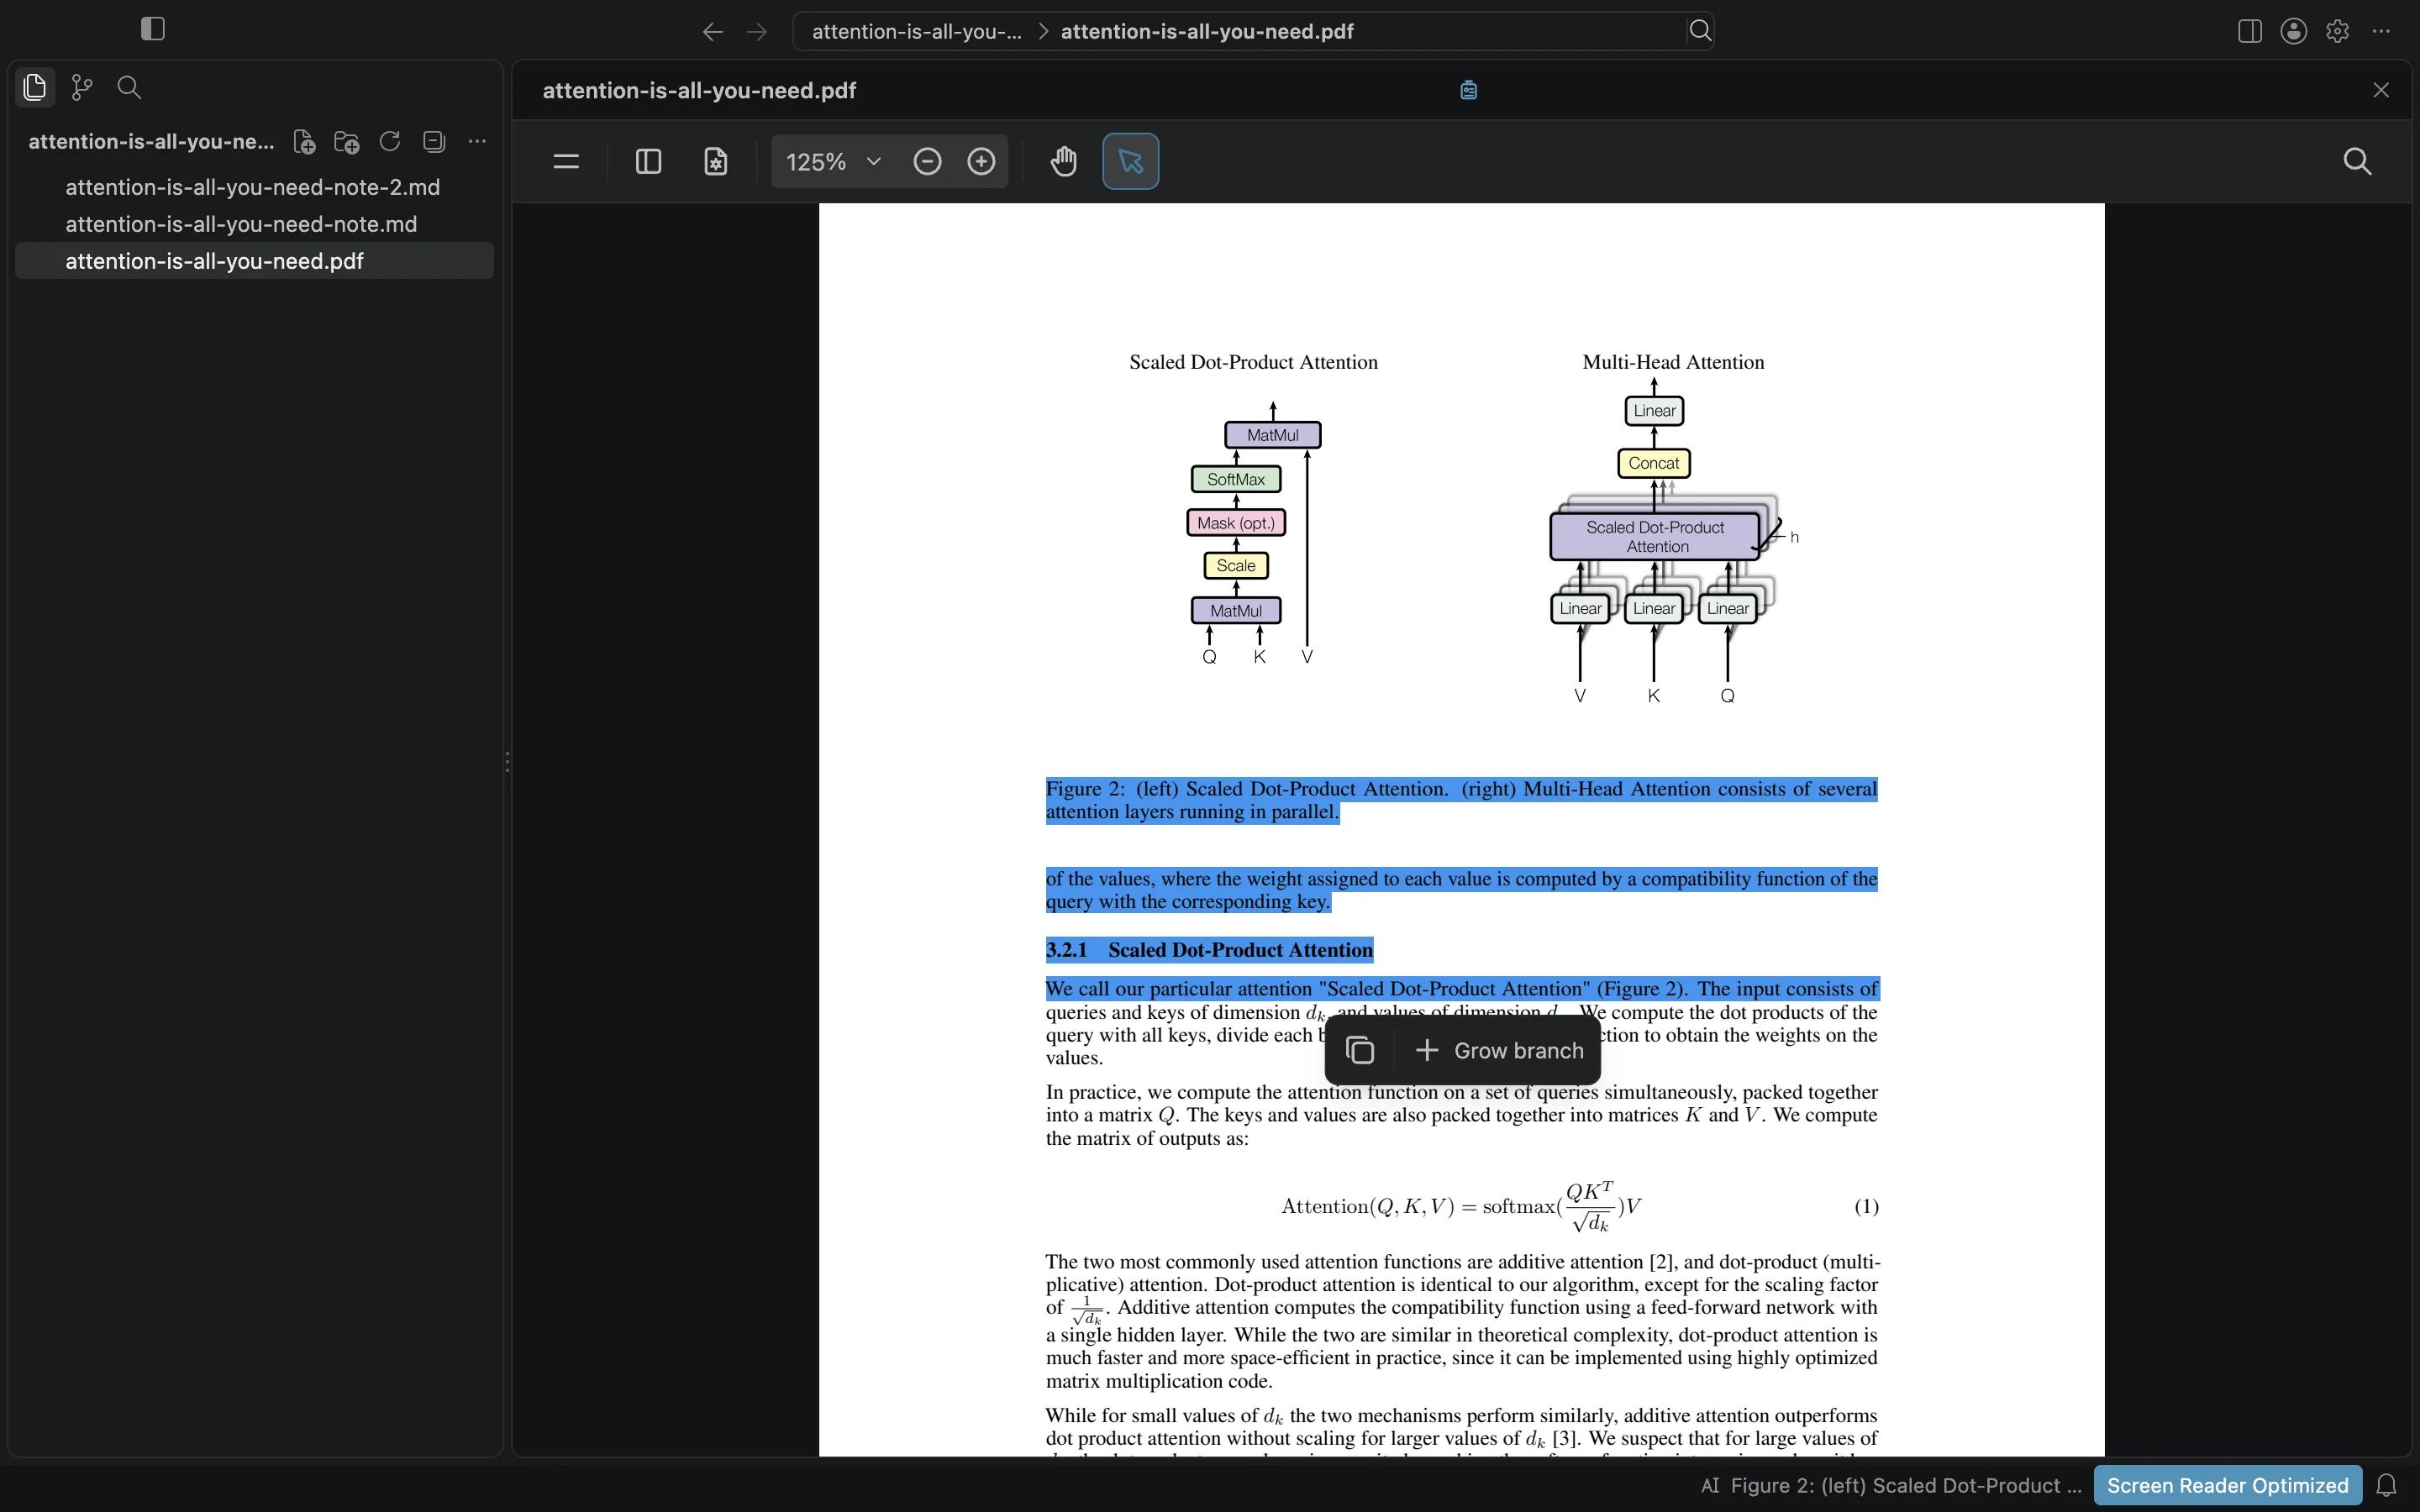
缩放点积注意力
03-scaled-dot-product.md 从第 4 页 Figure 2 旁边长出,几乎人人会重画的那张图。Query 发问,Key 是每个位置对外公布的内容,Value 是真正被混合的载荷。分数是缩放后的 Q·K,softmax 变成权重,输出是 V 的加权和。Multi-head 就是多路这样的注意力并行,再拼接投影。
第一天不必记全部分矩阵形状。卡片上留着图注和章节开头,引文下面是我们自己写的一小段心智模型。
同一种机制的三种接线
04-three-attention-uses.md 从 §3.2.3 长出。还是 multi-head,在原始的编码器-解码器 Transformer 里干三件事:
- 编码器自注意力,源序列位置看源序列
- 解码器带掩码的自注意力,目标位置只看左侧
- 编码器-解码器注意力,解码器的 query 看编码器的 memory
这三种接线一旦对上号,「attention is all you need」就不再像口号,而像一张零件表。
位置编码把顺序留下
05-positional-encoding.md 从第 6 页的正弦 / 余弦一节长出。纯注意力并不自带 token 顺序。论文把固定的正弦位置编码与 embedding 相加,让位置跟着内容走。后来的模型常常换配方;需要某种顺序信号这一点没有变。
练习:用一句话各说清 Q、K、V
五条分支之后,我们还想确认:离开那张图,Q / K / V 的故事是否还能说清楚。于是在画布上加了 06-qkv-practice.md,把它连到缩放点积、三种接线和循环瓶颈这几张卡,并各自用一句话回答四道题:
- 在缩放点积注意力里,Query 代表什么?
- Key 代表什么,它怎样和 Query 相遇?
- 权重定下来之后,Value 用来做什么?
- 为什么论文要用 multi-head,而不是一个很宽的单头?
卡片上我们自己的答案:
- Query 是当前位置在整段序列里要找的东西。
- Key 是每个位置对外公布的内容;Q 与 K 的缩放点积给匹配打分。
- Value 是真正被混合的载荷,注意力输出就是 Value 的加权和。
- 多个头并行,让模型保留不同视角(例如不同的依赖模式),而不是挤进一个平均后的单头。
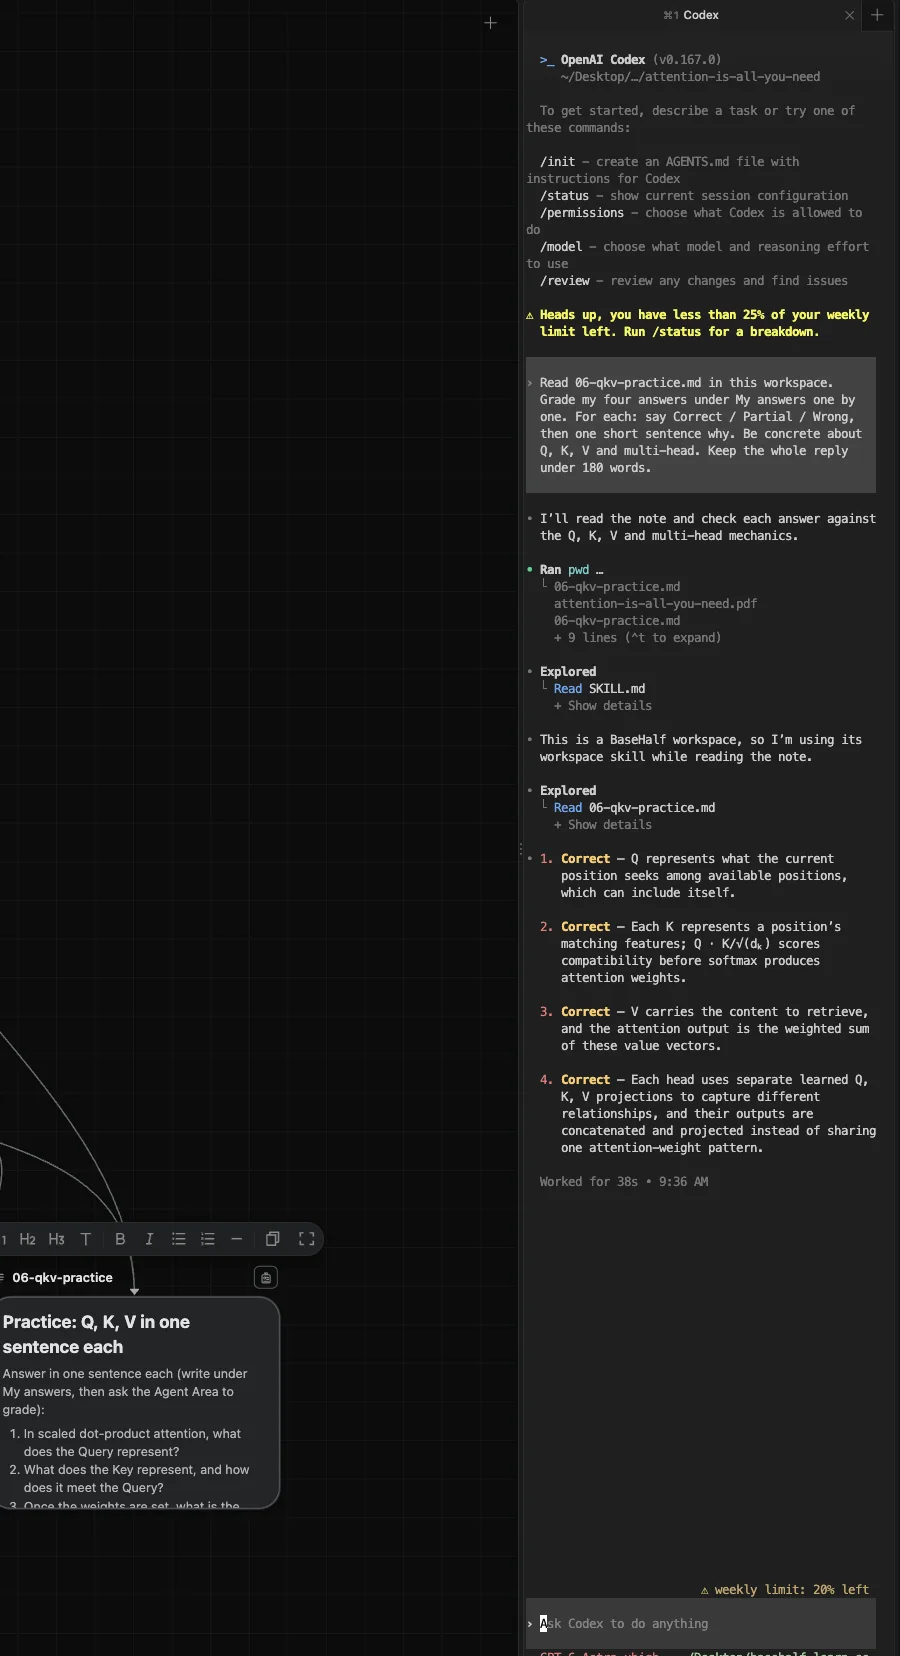
然后在同一文件夹打开 Agent Area,让 Codex 读 06-qkv-practice.md,按 Correct / Partial / Wrong 逐条批改并各给一句理由。它把四条都标成 Correct:Q 是当前位置在找的信息,K 是各位置的匹配特征,V 是权重取回的内容,multi-head 则是多套学到的 Q / K / V 投影,用来保留不同关系而不是一个被平均掉的头。
每条笔记带走什么
每条分支文件都以这样的 frontmatter 开头(路径相对文件夹):
upstream:
  - attention-is-all-you-need.pdf
练习卡还会加上它依赖的机制笔记。下面是长出来的引文(或练习题),再是我们用自己的话写的几句。PDF 仍是真相来源;笔记才是之后会反复打开的文件,不是一份聊天记录。只选中文字、不 Grow,仍然可以喂给当次提问;Grow 是为了让这段摘录继续喂后续工作。该留下来的就连上,这一问才用的就选中 说的是同一分法。
和论文行走顺序一致的由浅入深
- 摘要主张,注意力即架构
- 痛点,循环挡住并行训练
- 机制,缩放点积与 multi-head
- 布局,模型里注意力出现的三处
- 顺序,位置编码
- 检验,用一句话写 Q / K / V,并让 Agent Area 批改
这是我们顺着 PDF 实际长分支、再用练习卡收束的顺序,不是事后编的大纲。若还想看图解,Jay Alammar 的 The Illustrated Transformer 和 Harvard NLP 的 The Annotated Transformer 仍然适合接着读,当作阅读材料,而不是替代画布上的论文卡片。