
用 BaseHalf 和 AI 入门 URL 结构
我们在 BaseHalf 里打开真实的 url-structure 文件夹,把组件、authority 和百分号编码笔记摆成卡片,旁边放着 RFC 3986 的本地副本,把这些笔记写进练习卡片的 upstream,再在 Agent Area 用 Claude Code 把四道 URI 题判为正确。
检查一个 URI 时,最好把五个部分放在自己的卡片上,让 RFC 待在同一个文件夹里,让智能体同时看到这些笔记和练习答案。我们在桌面上建了一个普通文件夹,放进六份短 Markdown 和一份 RFC 3986 的本地副本,再用 BaseHalf 打开。窗口标题变成 url-structure,侧栏列出每一个文件,每个文件变成卡片。我们在右侧 Agent Area 启动了 Claude Code,并选中了练习卡片。
磁盘上的路径是 Desktop/basehalf-learn-sessions/url-structure/。画布上的文件是这些:
url-structure/
  00-goal.md
  01-components.md
  02-authority-and-no-authority.md
  03-percent-encoding.md
  04-practice.md
  rfc3986.txt
  sources.md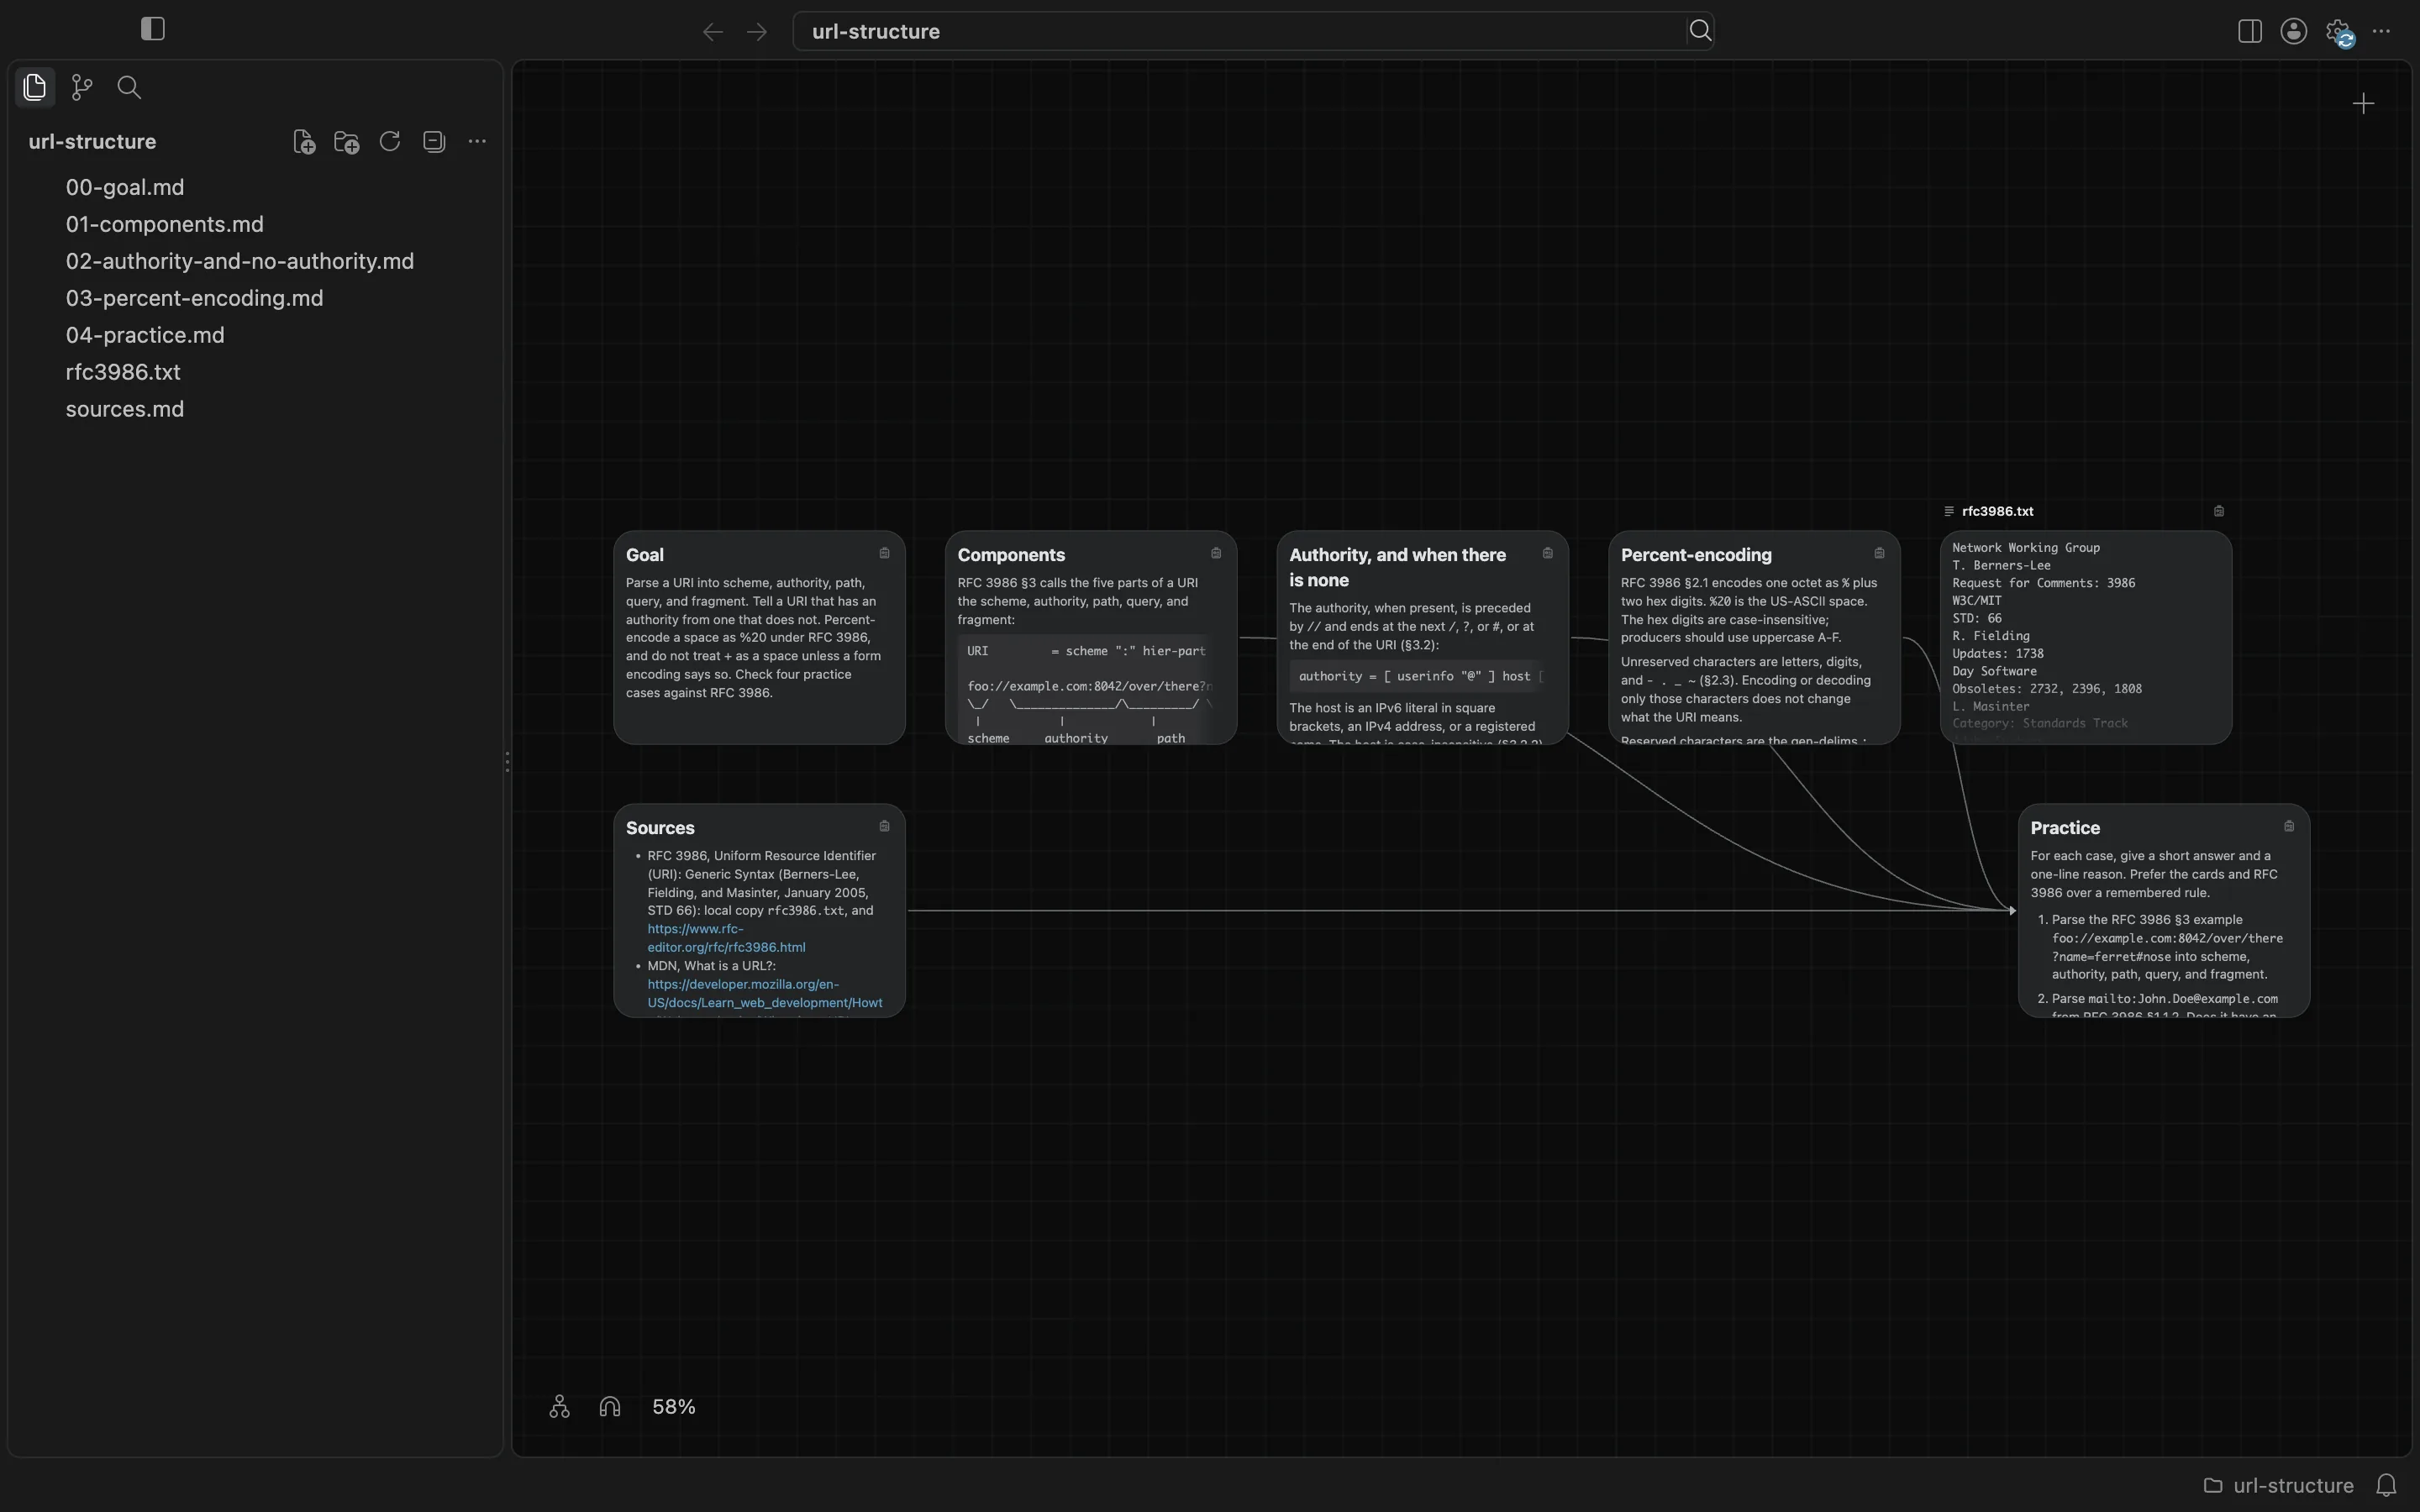
每张卡片写了什么
00-goal.md 划定范围:把一个 URI 解析成 scheme、authority、path、query 和 fragment;区分有 authority 和没有 authority 的 URI;按 RFC 3986 把空格百分号编码成 %20;再对照这份 RFC 核对四道练习。
01-components.md 记下 RFC 3986 第 3 节的五部分图:scheme、authority、path、query 和 fragment。scheme 和 path 是必需的,path 可以为空。只有分层部分以 // 开头时,才有 authority。fragment 会在解引用其余部分之前被拆下来,由用户代理使用,而不是由服务器上某个特定 scheme 的过程使用。笔记还写了第 1.1.3 节:URL 是那些还说明了如何定位资源的 URI 子集,这个文件夹沿用通用语法,并用 “URI” 这个词。
02-authority-and-no-authority.md 把 authority 写成 [ userinfo "@" ] host [ ":" port ]。host 是方括号里的 IPv6 字面量、IPv4 地址,或普通主机名(reg-name)。userinfo 里的 user:password 形式已不推荐。URI 不会仅仅因为含有 @ 就有 authority:mailto:[email protected] 没有 //。
03-percent-encoding.md 记下 % 加两个十六进制数字,%20 是 US-ASCII 空格,以及包括 + 在内的保留字符。它还写到,把 + 当作空格,是 application/x-www-form-urlencoded 的约定,不是通用语法的规则。
sources.md 链接了 RFC 3986(Berners-Lee、Fielding 和 Masinter,2005 年 1 月,STD 66),以及本地副本 rfc3986.txt,还有 MDN 的 What is a URL?。对这个文件夹来说,这些才是依据,而不是模型本身。
练习笔记上的 Upstream
练习笔记在 upstream 列表里写了三张概念卡片和 sources.md。画布上,从 01-components、02-authority-and-no-authority、03-percent-encoding 和 sources 出发的线,都进入 04-practice。文件开头是:
upstream:
  - 01-components.md
  - 02-authority-and-no-authority.md
  - 03-percent-encoding.md
  - sources.md
这份列表会留在文件里。选中不会:它只在 BaseHalf 打开时写在 .bh/cache/selection.yaml。我们选中了练习卡片,状态栏显示 04-practice,然后请 Claude Code 批改。
四道练习
练习卡片要求每道题写简短答案和一行理由,优先依据卡片和 RFC 3986,而不是凭记忆里的规则。
-
解析 RFC 3986 第 3 节的例子
foo://example.com:8042/over/there?name=ferret#nose,写出 scheme、authority、path、query 和 fragment。 -
解析 RFC 3986 第 1.1.2 节中的
mailto:[email protected]。它有 authority 吗?path 是什么? -
解析同一节中的
ldap://[2001:db8::7]/c=GB?objectClass?one。host 是什么?query 从哪里开始,第二个?会开始一个新的组成部分吗? -
希望在
https://example.com下,path 里包含中间有空格的两个词a和b。RFC 3986 会写出怎样的 URI?https://example.com/search?q=a+b是不是通用语法里,把 query 中a和b之间的空格编进去的写法?
我们的答案是:
-
scheme 是
foo,authority 是example.com:8042,path 是/over/there,query 是name=ferret,fragment 是nose。这就是 RFC 3986 第 3 节的组成图。 -
没有 authority:scheme 后面没有
//。path 是[email protected]。RFC 3986 第 3.3 节用同类例子mailto:[email protected],其 path 是[email protected]。 -
host 是写在方括号里的 IPv6 字面量
2001:db8::7,因此 authority 是[2001:db8::7]。query 从第一个?开始,内容是objectClass?one。第二个?是 query 里的数据;RFC 3986 第 3.4 节允许 query 中出现?,并不会因此开始一个新的组成部分。 -
URI 是
https://example.com/a%20b。空格不是 unreserved 字符,所以要百分号编码成%20。https://example.com/search?q=a+b不是通用语法里对空格的编码:+是保留的 sub-delim。把+当作空格,是表单编码的约定,不是 RFC 3986。
Claude Code 实际说了什么
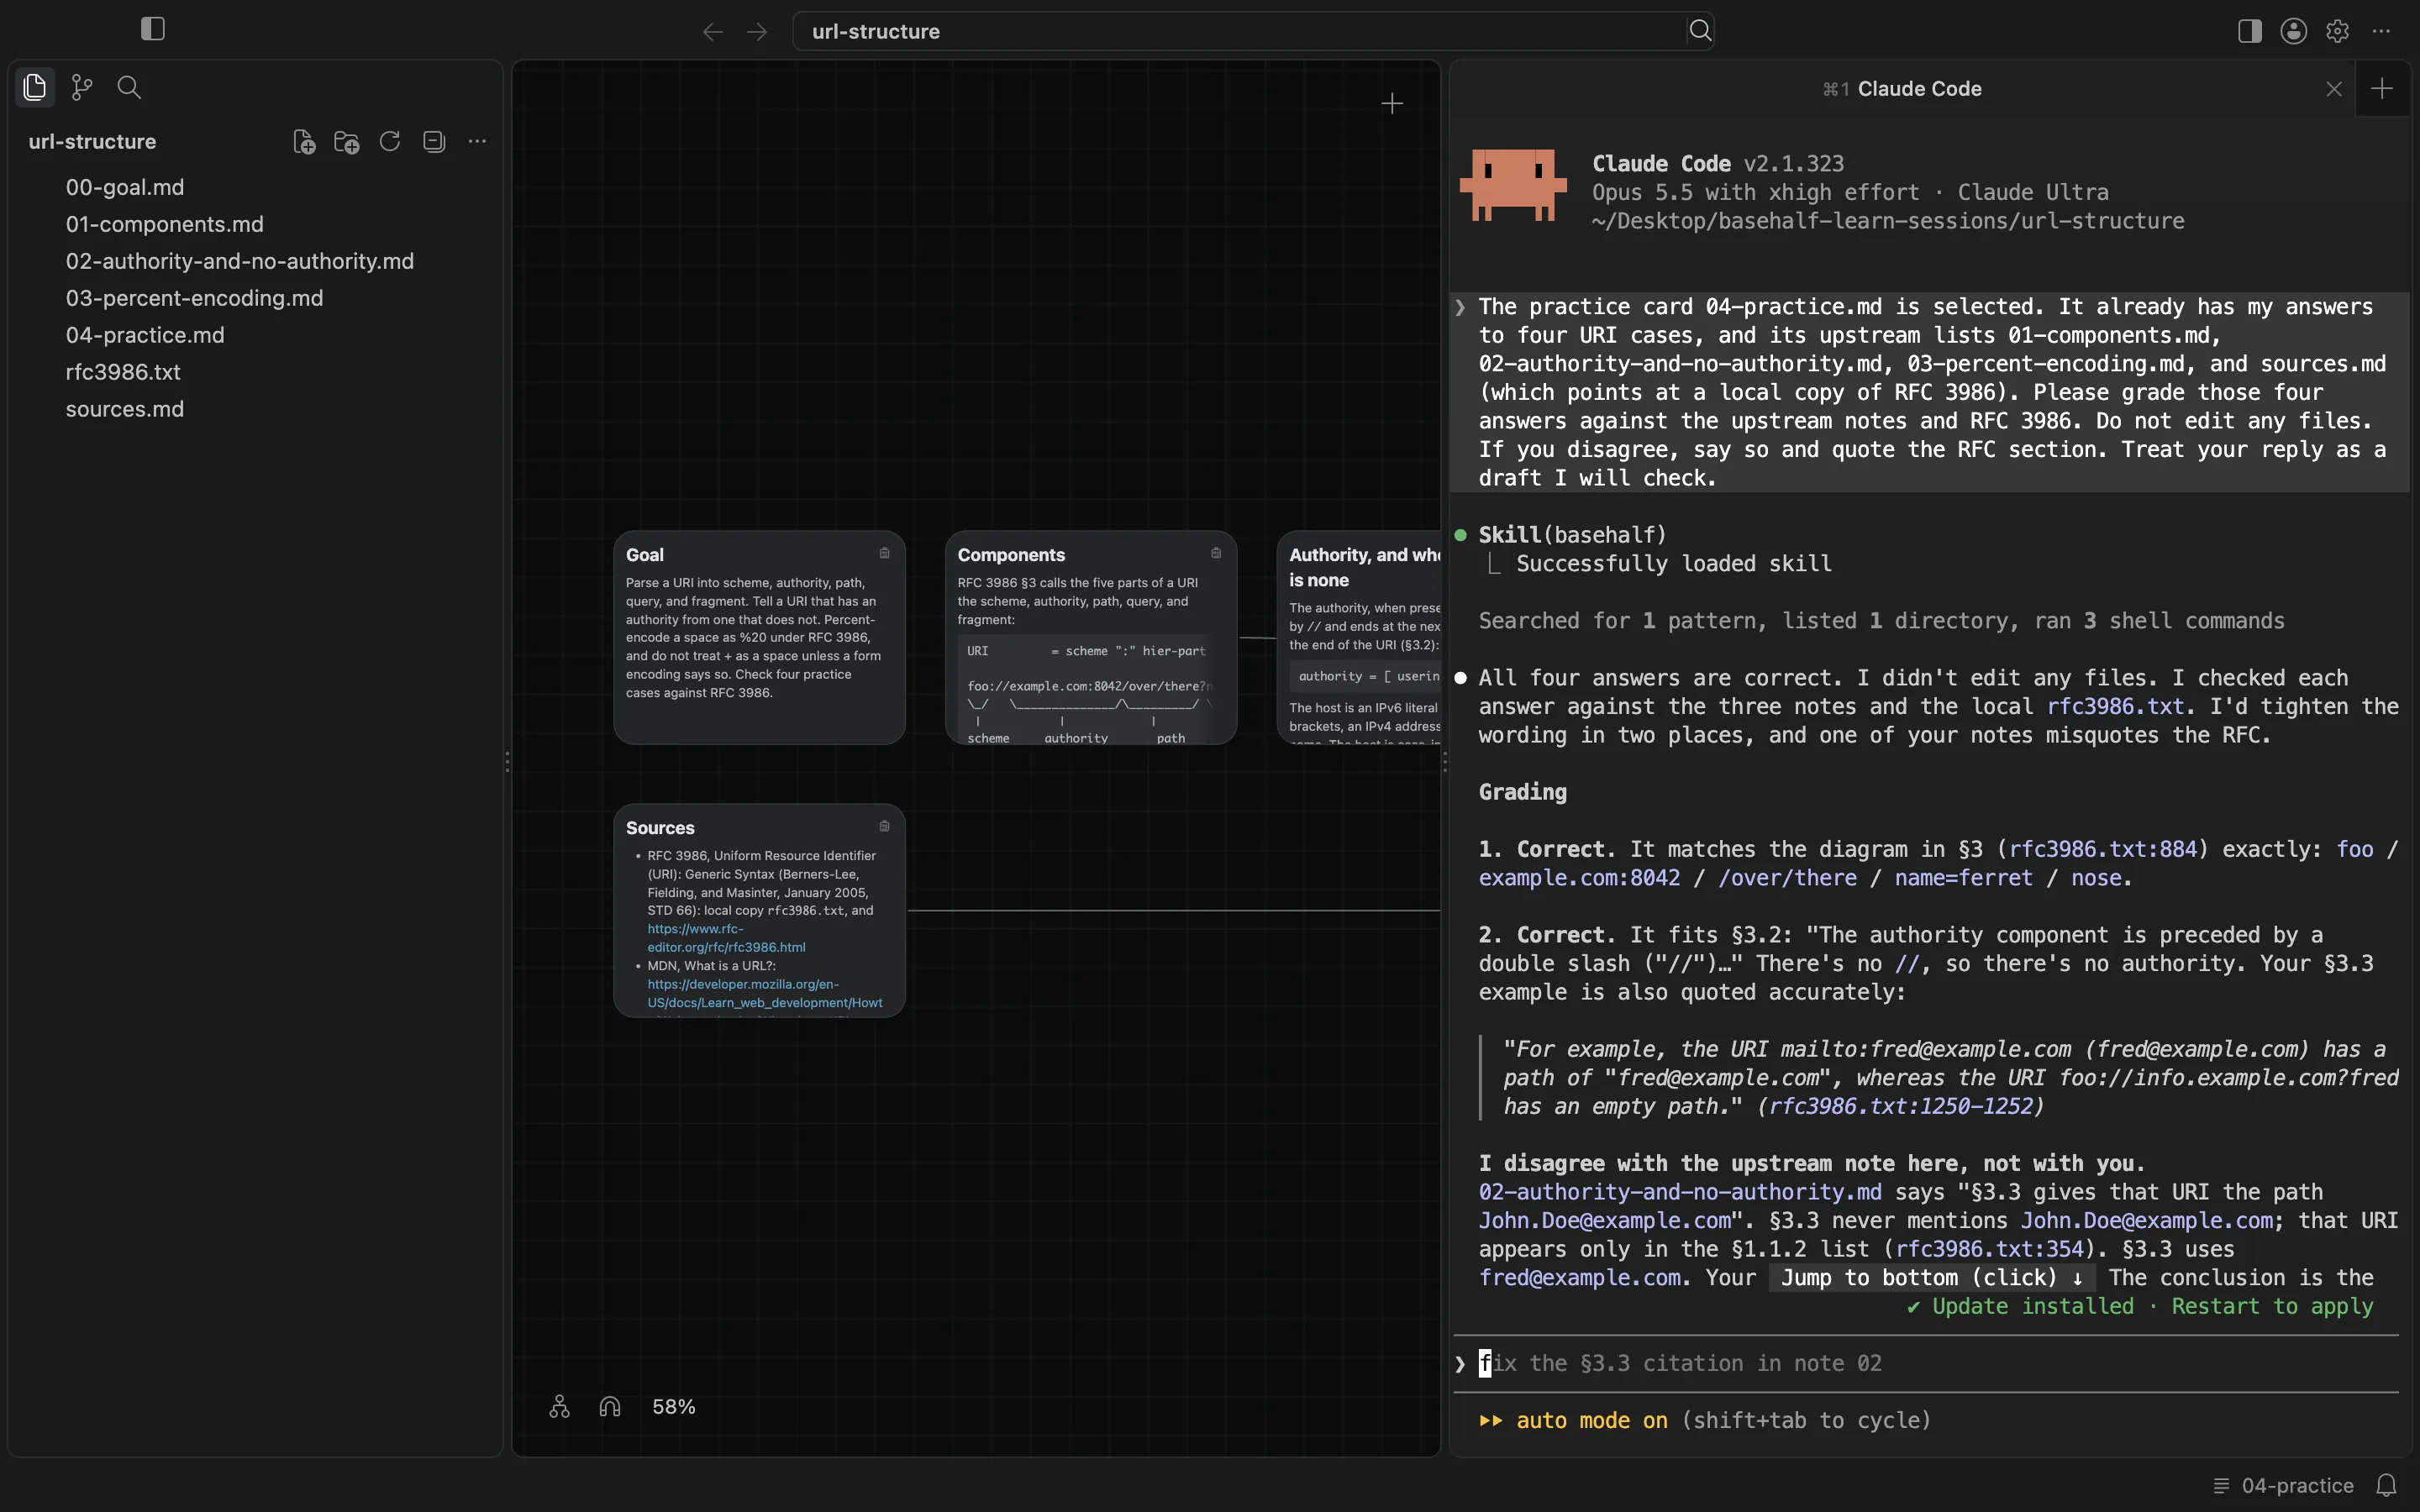
把回复当作草稿来看。这次会话里,Claude Code(v2.1.323,窗口里显示为 Opus 5.5、xhigh effort、Claude Ultra)说四道题都正确,它对照三张笔记和本地的 rfc3986.txt 逐题核对过,并且没有编辑任何文件。这一轮用了 1 分 9 秒。练习文件在磁盘上的时间戳,与会话开始前相同。
它把第一题对回第 3 节的组成图。第二题它引用了第 3.2 节:authority 前面是 //,这个 mailto URI 没有。它也准确引用了第 3.3 节:mailto:[email protected] 的 path 是 [email protected],而 foo://info.example.com?fred 的 path 为空。它不同意的是 authority 那张笔记,而不是练习答案。笔记写的是:第 3.3 节把 mailto:[email protected] 的 path 写成 [email protected]。这个邮箱只出现在第 1.1.2 节的例子列表里;第 3.3 节用的是 [email protected]。结论相同,但笔记的出处写得不严谨。我们核对了本地 RFC,这个区分是对的。
第三题它同意 query 是 objectClass?one,并引用第 3.4 节:query 从第一个 ? 开始,且 ? 可以表示 query 里的数据。它认为关于 host 的表述稍松。按 RFC 的文法,IP-literal 包含方括号,因此 host 子组件是 [2001:db8::7],2001:db8::7 是其中的 IPv6 地址。我们核对了这段 ABNF,更严谨的说法是对的。它还补充说,虽然题目没问,这条 URI 的 path 是 /c=GB。
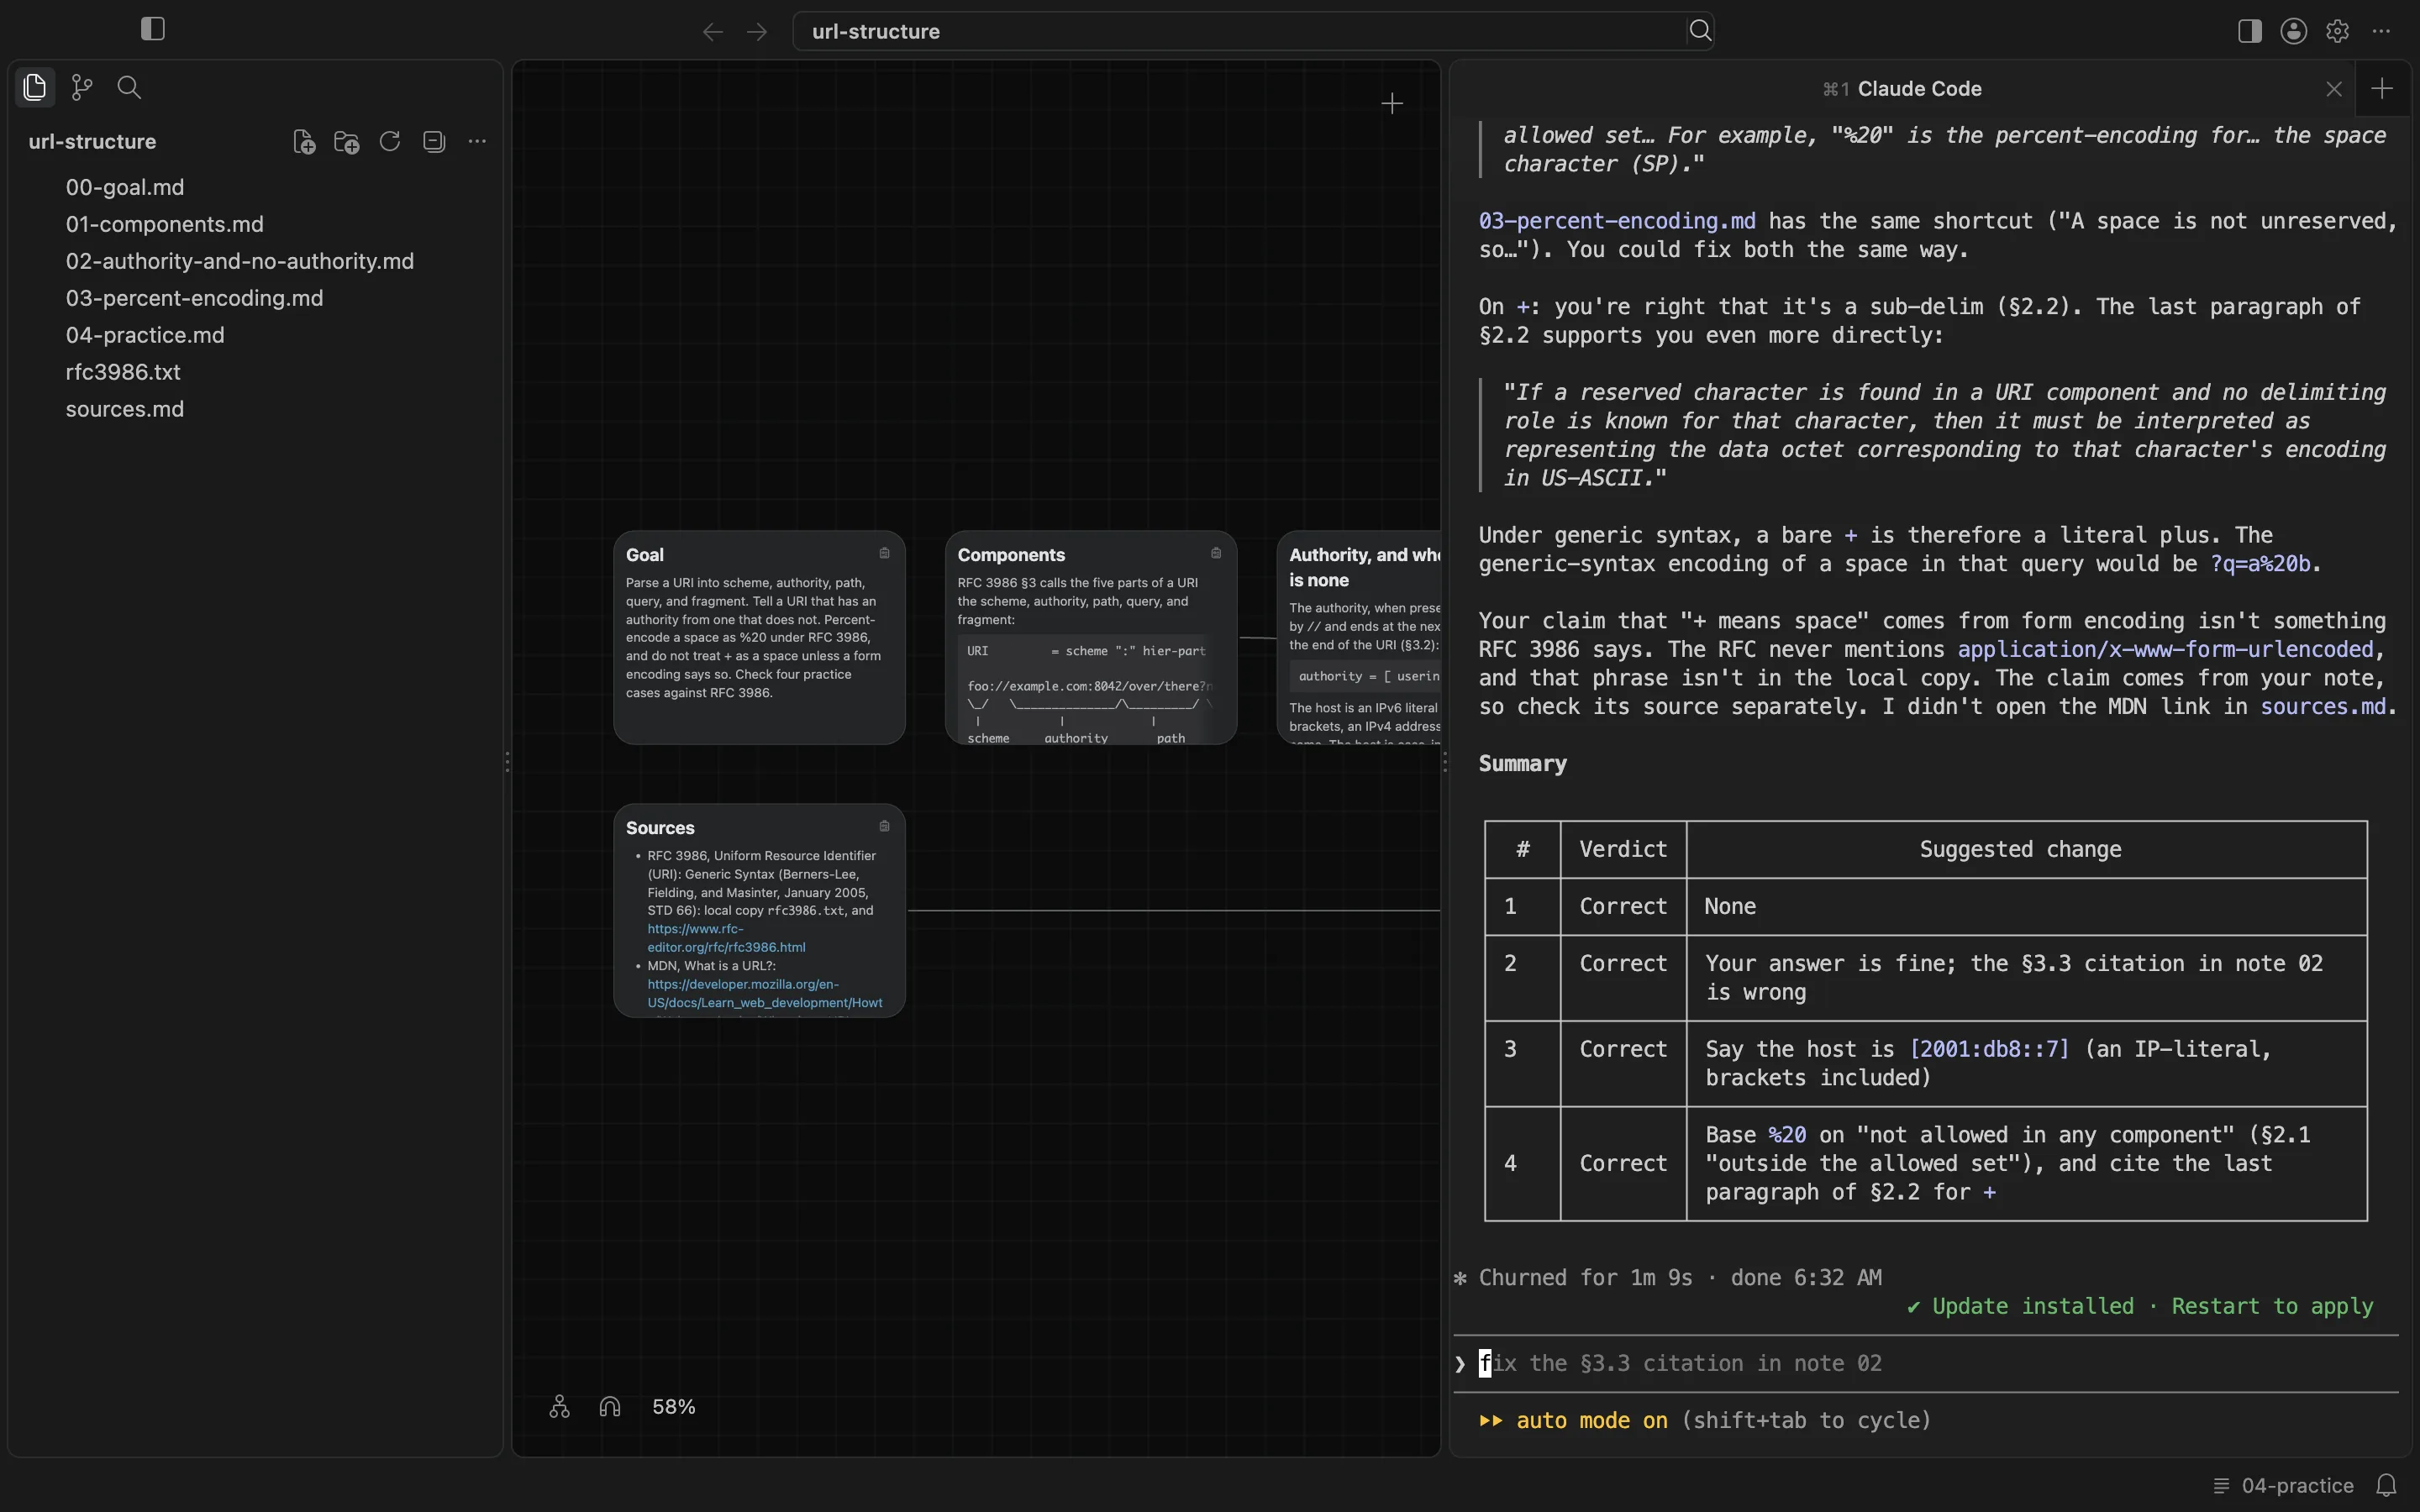
第四题它同意结论,但要求理由更紧。“空格不是 unreserved 字符,所以要百分号编码”,单凭这一句推不出来,因为保留字符同样不是 unreserved,却仍可能不以编码形式出现。第 2.1 节写的是:当某个数据八位组对应的字符不在允许集合里,或被用作分隔符时,才做百分号编码,并以 %20 作为空格的编码。这才是写出 https://example.com/a%20b 更稳妥的依据。我们核对了第 2.1 节,这个例子就在那里。
它也同意 + 是保留的 sub-delim,并引用第 2.2 节最后一段:如果在某个 URI 组件里遇到保留字符,又不知道它承担分隔作用,就必须把它读成对应的 US-ASCII 数据八位组。在通用语法下,单独的 + 因此是字面的加号,该 query 里空格的通用语法编码会是 ?q=a%20b。它接着指出我们百分号编码笔记里的一句话:RFC 3986 从未提到 application/x-www-form-urlencoded,本地副本里也没有这个词。把 + 当作空格的表单编码说法来自笔记,而不是来自 RFC,应当对照真正定义该约定的资料来核对。Claude Code 说它没有打开 sources.md 里的 MDN 链接。我们同意 RFC 没有提到表单编码。那句话是我们按常见的 HTML 表单约定写进去的,并不是 RFC 3986 的原文,不该写得像是 RFC 说过一样。
这次会话能说明什么,不能说明什么
四道做过的题只是起点,并不是读完了 RFC 3986。我们没有走相对解析、规范化,也没有看第 7 节的安全说明。模型可能写错章节或行号;核对要以本地 RFC 为准,这次我们核过的章节引文是成立的。之后可以继续用同一个文件夹,先改紧那两处笔记,再往下学。